در این مقاله
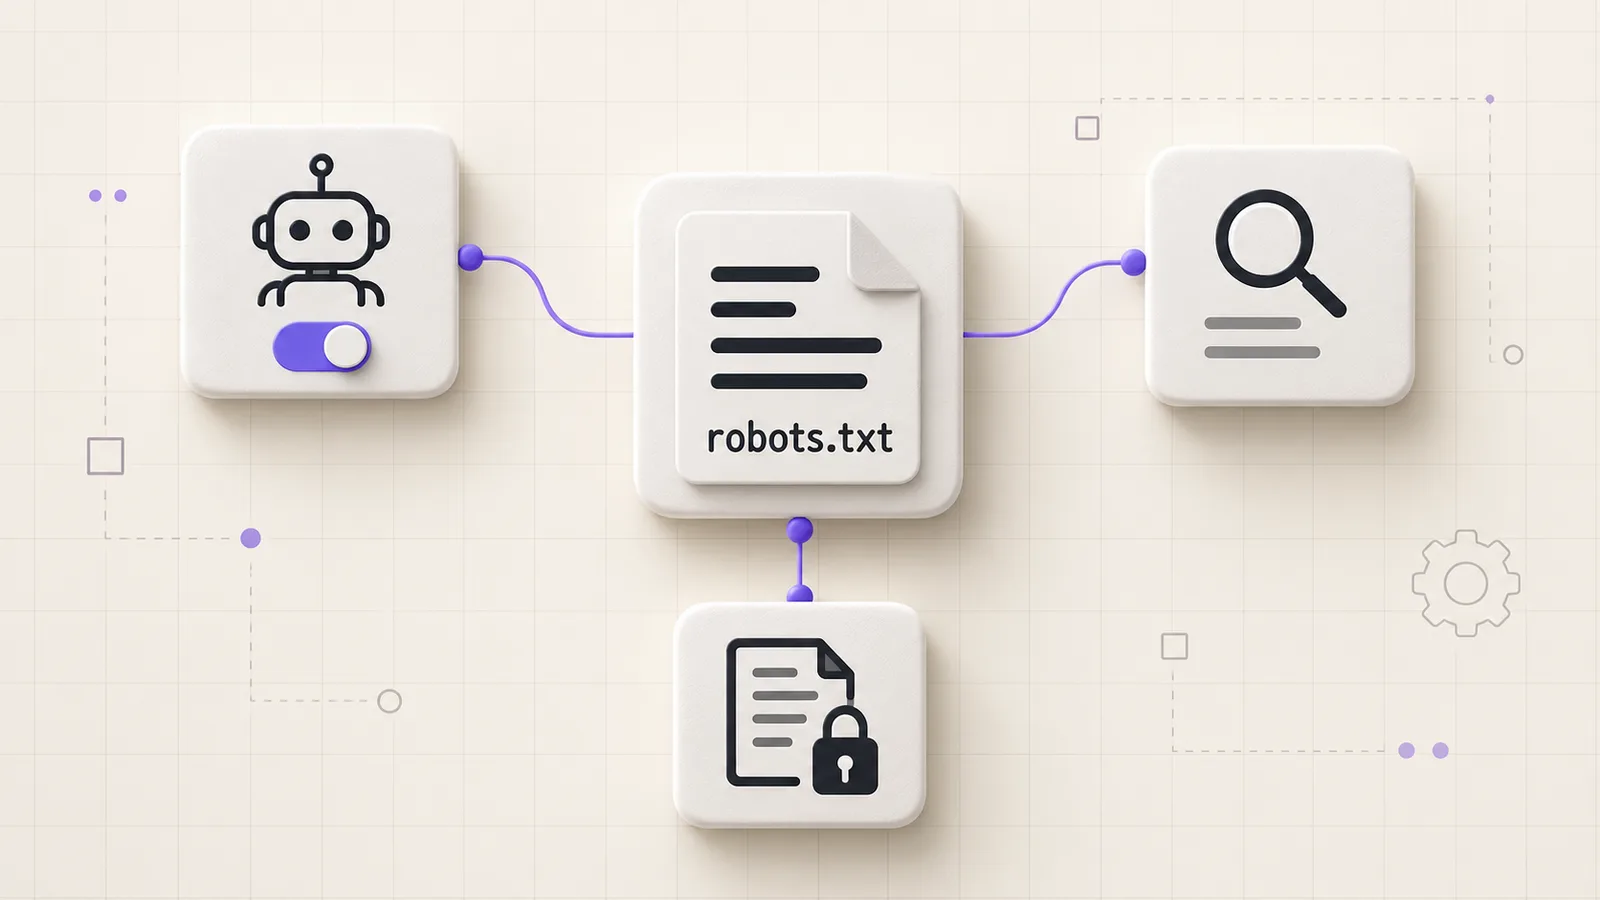
جلوگیری از استفاده آموزشی AI از محتوای سایت، جلوگیری از خزش و حذف صفحه از نتایج جستوجو یک کار واحد نیستند. اگر این سه هدف را با هم اشتباه بگیرید، ممکن است برای محدودکردن آموزش مدل، دسترسی لازم برای دیدهشدن سایت را هم ببندید یا برعکس تصور کنید فایل robots.txt از اطلاعات خصوصی محافظت میکند. ابتدا هدف را مشخص کنید و بعد قرارداد هر کنترل را بخوانید.
این راهنما در ۳۱ اکتبر ۲۰۲۶ تهیه شده است. گوگل در اطلاعیه ۳۰ اکتبر از برنامه حمایت از یک کنترل مشترک آموزشی در robots.txt خبر داده و هدف پشتیبانی را سال ۲۰۲۷ دانسته است. بنابراین از یک پیشنهاد در حال تکامل صحبت میکنیم، نه قابلیتی که امروز همه ارائهدهندگان به شکل قطعی اجرا میکنند. این تفاوت زمانی باید در تصمیم سایت حفظ شود.
سه پرسش مستقل پیش از تغییر فایل
اول بپرسید آیا میخواهید ربات محتوا را دریافت کند. دوم مشخص کنید آیا صفحه باید در جستوجو قابل نمایش باشد. سوم تصمیم بگیرید استفاده از محتوا برای آموزش مدل چه سیاستی دارد. ممکن است پاسخ این سه پرسش متفاوت باشد. یک مقاله عمومی میتواند برای جستوجو قابل دسترس باشد اما ناشر درباره کاربرد آموزشی آن ترجیح دیگری اعلام کند.
برای داده خصوصی، پرسش چهارم هم لازم است: چه کسی اجازه خواندن دارد؟ این موضوع با احراز هویت و مجوز سرور حل میشود، نه با یک خط در robots.txt. مسیر مدیریت، بکاپ یا فایل مشتری را با امید به رعایت دستور خزنده عمومی نکنید. درج مسیر در فایل عمومی حتی میتواند محل آن را آشکار کند؛ مرز امنیتی باید مستقل از رفتار ربات باشد.
خبر جدید گوگل دقیقاً چه میگوید؟
اطلاعیه کنترل مشترک آموزش AI از یک توکن سیاست در robots.txt صحبت میکند تا ترجیح آموزشی میان ارائهدهندگان مشارکتکننده بیان شود. گوگل میگوید کنترلهای اختصاصی موجود کنار این سیگنال باقی میمانند. این خبر را نباید به «حذف همه تنظیمات فعلی و جایگزینی فوری با یک استاندارد نهایی» ترجمه کرد.
برنامه اعلامی برای ۲۰۲۷ است و جزئیات پیشنویس ممکن است تغییر کند. این مقاله دستور عملی فعالسازی یک قابلیت همگانی ارائه نمیدهد. هنگام تصمیم، نسخه پیشنویس، تاریخ بررسی و اعلام پشتیبانی واقعی هر شرکت را ثبت کنید. یک مقاله ثالث یا وجود یک مثال کد، بهتنهایی اثبات نمیکند سرویس مقصد همین حالا آن ترجیح را اجرا میکند.
robots.txt چه قراردادی دارد؟
فایل robots.txt یک راه اعلام قواعد دریافت محتوا برای خزندههای رعایتکننده است. استاندارد Robots Exclusion Protocol قواعد پایه را توضیح میدهد. این سازوکار درِ قفلشده نیست؛ کاربر یا ابزار نامتعارف ممکن است بدون رعایت آن فایل را بخواند. پس برای صفحه خصوصی، محدودیت واقعی دسترسی همچنان لازم است.
محل فایل، پاسخ HTTP و گروه User-agent اهمیت دارند. چند افزونه، CDN و فایل فیزیکی ممکن است برداشت متفاوتی از «فایل فعلی» ایجاد کنند. قبل از ویرایش، پاسخ عمومی دامنه را بخوانید و ببینید کدام لایه آن را تولید میکند. تغییر در پیشخوان بدون تغییر پاسخ عمومی یعنی اقدام شما هنوز به مسیر واقعی خزنده نرسیده است.
noindex با Disallow یکی نیست
دستور noindex برای کنترل حضور صفحه در ایندکس کاربرد دارد و باید طبق قرارداد موتور جستوجو دیده و پردازش شود. بستن دریافت صفحه در robots.txt میتواند مانع دیدن دستور داخل همان صفحه شود. بنابراین این دو را بدون شناخت ترکیب نکنید. راهنمای رسمی noindex گوگل تفاوت و روش بررسی را توضیح میدهد.
حذف از سایتمپ هم جای noindex یا محافظت از داده را نمیگیرد. صفحهای که لینک دیگری دارد ممکن است همچنان کشف شود. برای هر هدف، ابزار مناسب را انتخاب کنید: کشف، دریافت، ایندکس و دسترسی خصوصی چهار لایهاند. نتیجه را با ابزار بررسی همان لایه بسنجید و از یک پاسخ ۲۰۰ یا نبودن URL در یک فایل، نتیجه امنیتی یا رتبهای نگیرید.

نظرات کاربران (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.