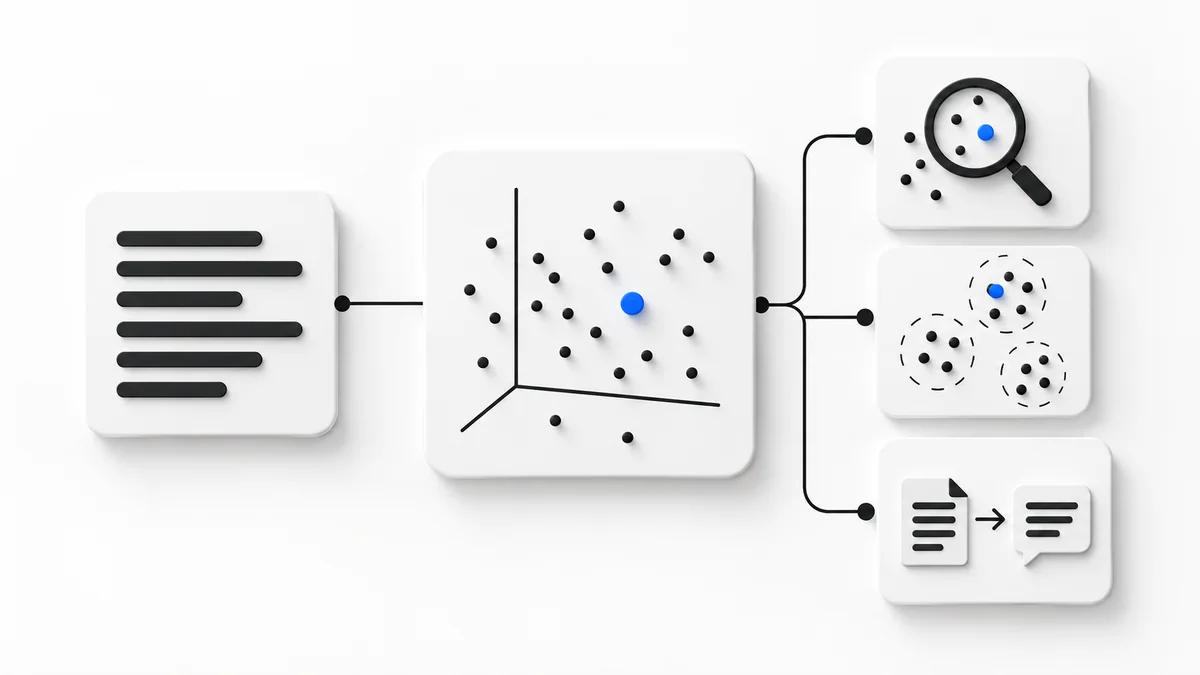
Embedding نمایش عددی متن است. مدل، یک واژه، جمله یا سند را به آرایهای از عددها تبدیل میکند؛ متنهایی که از نظر معنایی نزدیکاند معمولاً در فضای برداری هم فاصله کمتری دارند. به همین دلیل میتوان «لغو سفارش» را به «چطور خریدم را پس بدهم؟» مرتبط دانست، حتی اگر واژههای یکسان کمی داشته باشند.
Embedding خودش پاسخ متنی تولید نمیکند. خروجی آن برای مقایسه، بازیابی و دستهبندی استفاده میشود. اگر میخواهید مدل درباره سندهای شما پاسخ بدهد، Embedding مرحله بازیابی در یک سیستم RAG را میسازد و مدل گفتگو مرحله تولید پاسخ را انجام میدهد.
بردار Embedding چیست؟
بردار فهرستی با طول ثابت از عددهای اعشاری است؛ مثلاً ۷۶۸، ۱۰۲۴ یا ۱۵۳۶ مقدار. هر بُعد را نباید مثل یک برچسب مستقل تفسیر کرد. معنا در الگوی کلی عددها و رابطه آن بردار با بردارهای دیگر قرار دارد.
دو متن را با یک مدل و تنظیم یکسان Embed میکنیم و فاصله بردارهایشان را میسنجیم. هرچه فاصله کمتر یا Similarity بیشتر باشد، مدل آنها را از نظر معنایی نزدیکتر دیده است. این شباهت احتمال است، نه اثبات ارتباط.
Embedding چه کاربردهایی دارد؟
- جستوجوی معنایی: پیداکردن نتیجه مرتبط بدون وابستگی کامل به واژه دقیق؛
- RAG: بازیابی بخش مناسب سند پیش از تولید پاسخ؛
- دستهبندی: نزدیککردن متن جدید به نمونههای برچسبخورده؛
- خوشهبندی: گروهبندی بازخوردها یا تیکتهای مشابه؛
- تشخیص محتوای نزدیک: یافتن متنهای تکراری یا بازنویسیشده؛
- پیشنهاد محتوا: نمایش مقاله یا محصول شبیه به مورد فعلی.
جستوجوی معنایی چه فرقی با جستوجوی کلمهای دارد؟
Full-text search در پیداکردن عبارت دقیق، نام، شناسه محصول و کد خطا قوی است. Vector search رابطه معنایی را بهتر میبیند. هیچکدام همیشه برنده نیستند. در سیستم واقعی، Hybrid search نتیجههای واژهای و برداری را ترکیب میکند و معمولاً برای متن فارسی انتخاب مطمئنتری است.
| نیاز | روش مناسب |
|---|---|
| کد خطا یا عبارت دقیق | Full-text یا فیلتر ساختاریافته |
| پرسش با بیان متفاوت | Vector search |
| هر دو نوع پرسش | Hybrid search |
شباهت کسینوسی چیست؟
Cosine similarity زاویه دو بردار را مقایسه میکند. برای بسیاری از مدلهای متنی، این معیار نقطه شروع خوبی است. pgvector عملگر <=> را برای فاصله کسینوسی دارد و میتوان شباهت را با 1 - distance نمایش داد.
SELECT content,
       1 - (embedding <=> $1::vector) AS similarity
FROM document_chunks
ORDER BY embedding <=> $1::vector
LIMIT 5;
آستانه ثابت را از مقاله یا نمونه عمومی کپی نکنید. توزیع امتیاز به مدل، نوع سند و طول متن بستگی دارد. آستانه را با مجموعه سؤالهای واقعی تعیین کنید.
ابعاد بردار چه اثری دارد؟
بردار بزرگتر فضای بیشتری برای نمایش رابطهها دارد، اما ذخیرهسازی، حافظه و هزینه جستوجو را بالا میبرد. ابعاد بالاتر لزوماً روی داده شما نتیجه بهتر نمیدهد. بعضی مدلها پارامتر dimensions دارند؛ اگر آن را تغییر دهید، Schema دیتابیس و همه بردارهای قبلی باید با همان اندازه هماهنگ باشند.
بردارهای ساختهشده با دو مدل متفاوت قابل مقایسه نیستند. نام مدل، ابعاد، نسخه پردازش متن و زمان ساخت را کنار رکورد ذخیره کنید.