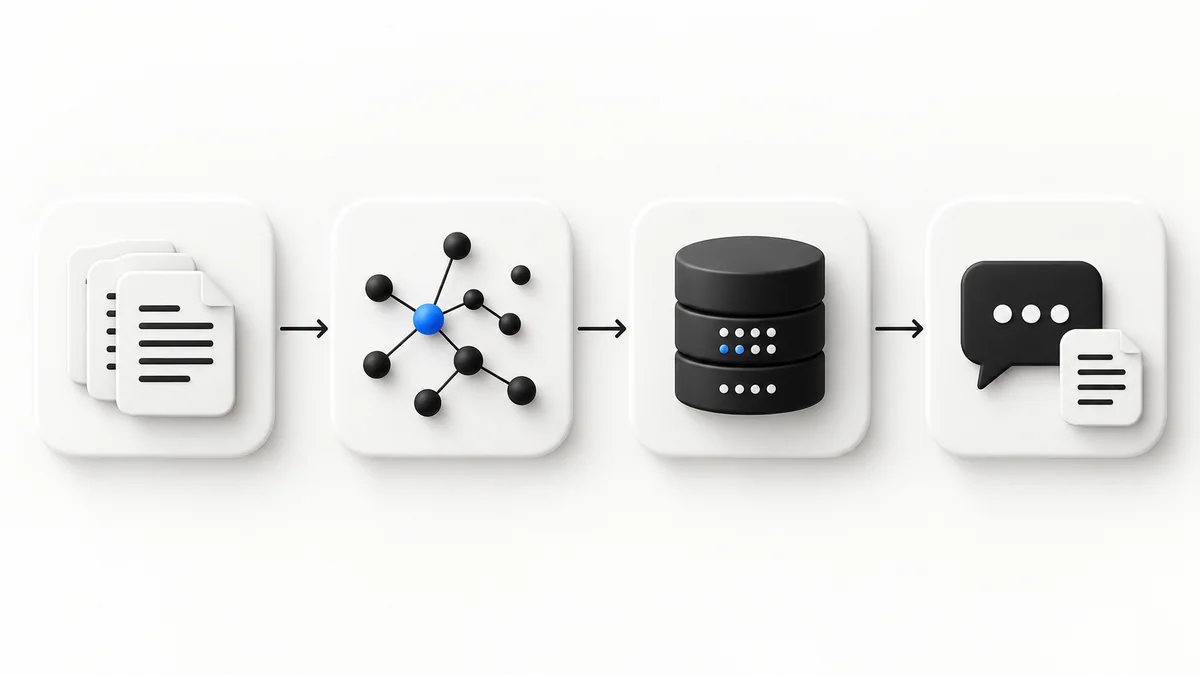
تقسیم سند به Chunk
تقسیم صرف بر اساس تعداد کاراکتر ممکن است جمله یا جدول را از وسط ببرد. برای نسخه اول، پاراگرافها را جمع کنید تا به حدود ۵۰۰ تا ۸۰۰ توکن برسید و بین Chunkها کمی همپوشانی بگذارید. عنوان بخش، مسیر سند و تاریخ بهروزرسانی را به Metadata اضافه کنید.
function chunkText(text, maxChars = 2400) {
  const paragraphs = text.split(/\n\s*\n/).map(x => x.trim()).filter(Boolean);
  const chunks = [];
  let current = "";
  for (const paragraph of paragraphs) {
    if (current && current.length + paragraph.length > maxChars) {
      chunks.push(current);
      current = current.slice(-300) + "\n\n" + paragraph;
    } else current += (current ? "\n\n" : "") + paragraph;
  }
  if (current) chunks.push(current);
  return chunks;
}
عدد مناسب جهانی وجود ندارد. Chunk را با سؤالهای واقعی و معیار بازیابی ارزیابی کنید، نه فقط با طول ثابت.
ساخت Embedding با API پاستا
مسیر پاستا با قالب OpenAI سازگار است و یک رشته یا آرایه متن را میپذیرد. ارسال آرایه، هزینه شبکه را برای Ingest چند Chunk کم میکند. در هر درخواست حداکثر ۲۰۴۸ ورودی و بدنه ۲ مگابایت پذیرفته میشود؛ برای فایل بزرگ Batchهای کوچکتر بسازید.
import OpenAI from "openai";

const ai = new OpenAI({
  apiKey: process.env.PAASTA_AI_KEY,
  baseURL: "https://console.paasta.cloud/api/ai/v1",
});

const result = await ai.embeddings.create({
  model: process.env.EMBEDDING_MODEL,
  input: chunks,
  dimensions: 1536,
});

const vectors = result.data.map(item => item.embedding);
پارامتر dimensions فقط برای مدلی استفاده شود که آن را پشتیبانی میکند. مدل، ابعاد و نسخه Chunking را کنار هر رکورد ثبت کنید؛ تغییر مدل معمولاً Re-embedding همه سندها را لازم میکند.
ذخیره امن Chunk و بردار
await db.query(
  `INSERT INTO document_chunks(document_id, source_url, content, embedding)
   VALUES ($1, $2, $3, $4::vector)`,
  [documentId, sourceUrl, chunk, JSON.stringify(vector)]
);
برای جلوگیری از SQL injection همیشه پارامتر Binding داشته باشید. اگر سند مشتریان مختلف را نگه میدارید، tenant_id را اجباری کنید و همان شرط را در تمام Queryهای بازیابی بیاورید؛ شباهت برداری نباید مرز Tenant را دور بزند.
بازیابی متن مرتبط با سؤال
سؤال را با همان مدل و همان ابعاد به بردار تبدیل کنید. سپس فاصله کسینوسی را مرتب کنید:
SELECT document_id, source_url, content,
       1 - (embedding <=> $1::vector) AS similarity
FROM document_chunks
WHERE tenant_id = $2
ORDER BY embedding <=> $1::vector
LIMIT 5;
عدد پنج فقط نقطه شروع است. یک آستانه شباهت بگذارید تا وقتی سند مرتبطی نیست، سیستم صریحاً بگوید پاسخ کافی ندارد. برای نام محصول، کد خطا و عبارت دقیق، جستوجوی Hybrid شامل Full-text و Vector معمولاً از Vector تنها بهتر است.
تولید پاسخ همراه Citation
const context = rows.map((row, i) =>
`[${i + 1}] ${row.content}\nSource: ${row.source_url}`
).join("\n\n");
const answer = await ai.chat.completions.create({
model: process.env.CHAT_MODEL,
messages: [
{ role: "system", content: "فقط با منابع دادهشده پاسخ بده. اگر کافی نیست، صریح بگو. شماره منبع را ذکر کن." },
{ role: "user", content: `سؤال: ${question}\n\nمنابع:\n${context}` },
],
});
Citation تولیدشده توسط مدل را کورکورانه نپذیرید. شمارههای مجاز را به Chunkهای واقعی نگاشت کنید و فقط URLهایی را نمایش دهید که واقعاً بازیابی شدهاند.
RAG فارسی را چگونه ارزیابی کنیم؟
- Recall بازیابی: آیا Chunk درست در پنج نتیجه اول است؟
- پاسخ مستند: آیا هر ادعا از Context قابل پشتیبانی است؟
- امتناع درست: وقتی منبع کافی نیست، آیا مدل از حدسزدن خودداری میکند؟
- هزینه: هزینه Ingest جدا از هزینه هر سؤال ثبت میشود؟
- تازگی: سند تغییرکرده دوباره Embed و نسخه قدیمی حذف میشود؟
برای فارسی، سؤالهای محاورهای، نیمفاصله، املای جایگزین و متن ترکیبی فارسی و انگلیسی را در مجموعه آزمون بگذارید. کیفیت مدلها را با همان اسناد خودتان مقایسه کنید.
کنترل هزینه و خطا
Embedding سند یک هزینه Ingest است و تا وقتی متن عوض نشده لازم نیست تکرار شود. Hash محتوای پاکسازیشده را ذخیره کنید و فقط Chunk تغییرکرده را دوباره Embed کنید. برای Queryها Cache کوتاه، Batch ورودی و کلید جدا با سقف مصرف بگذارید.
در API پاستا پاسخ معتبر شامل مصرف و مبلغ نهایی است. خطای Provider یا پاسخ ناقص هزینه ندارد. خطاهای ۴۲۹ و ۵xx را با Backoff محدود مدیریت کنید و هیچ درخواست ناموفق را بهعنوان بردار صفر ذخیره نکنید.
RAG یا Fine-tuning؟
RAG برای دانش متغیر، سند خصوصی و پاسخ همراه منبع مناسب است. Fine-tuning بیشتر برای تغییر سبک، قالب و رفتار تکرارشونده مدل استفاده میشود. اگر مشکل «مدل سند جدید ما را نمیداند» است، معمولاً RAG نقطه شروع منطقیتری است.
استقرار نسخه اول
API Ingest و Query را میتوانید روی هاست Node.js یا هاست Python اجرا کنید. Secretها را در متغیر محیطی نگه دارید، Ingest را از endpoint عمومی جدا کنید و برای فایل بزرگ Job پسزمینه بسازید. دیتابیس برداری باید Backup و مانیتورینگ مستقل داشته باشد.
جمعبندی
یک RAG قابل اعتماد از چهار قطعه ساده ساخته میشود: Chunk مناسب، Embedding ثابت، بازیابی قابل ارزیابی و پاسخ محدود به منبع. با یک سند و چند سؤال واقعی شروع کنید؛ وقتی کیفیت بازیابی روشن شد، Index، Hybrid search و Reranking را اضافه کنید.
پیش از پیادهسازی: Embedding چیست؟
اگر با بردار، شباهت کسینوسی و انتخاب مدل آشنا نیستید، ابتدا راهنمای Embedding و جستوجوی معنایی را بخوانید.