مرحله دوم: کلید API پاستا را بسازید
- در کاتالوگ پاستا مدل مناسب را بر اساس قیمت، Context و پشتیبانی از ابزار انتخاب کنید.
- یک کلید مستقل برای n8n بسازید و فقط مدلهای لازم را مجاز کنید.
- سقف هزینه و نرخ درخواست را برای آزمایش پایین نگه دارید.
- کلید را در Credentials یا Secretهای n8n ذخیره کنید؛ آن را داخل متن Node یا Workflow Export قرار ندهید.
Endpoint سازگار با OpenAI پاستا https://console.paasta.cloud/api/ai/v1/chat/completions است. جزئیات Header، Streaming و قالب پیامها در مستندات API هوش مصنوعی پاستا آمده است.
مرحله سوم: ورودی Workflow را بسازید
برای آزمایش تعاملی از Chat Trigger استفاده کنید. اگر قرار است برنامه دیگری Agent را صدا بزند، Webhook Trigger مناسبتر است. ورودی را پیش از تحویل به مدل اعتبارسنجی کنید و طول متن، نوع فایل و نرخ درخواست را محدود نگه دارید.
مرحله چهارم: AI Agent و مدل را اضافه کنید
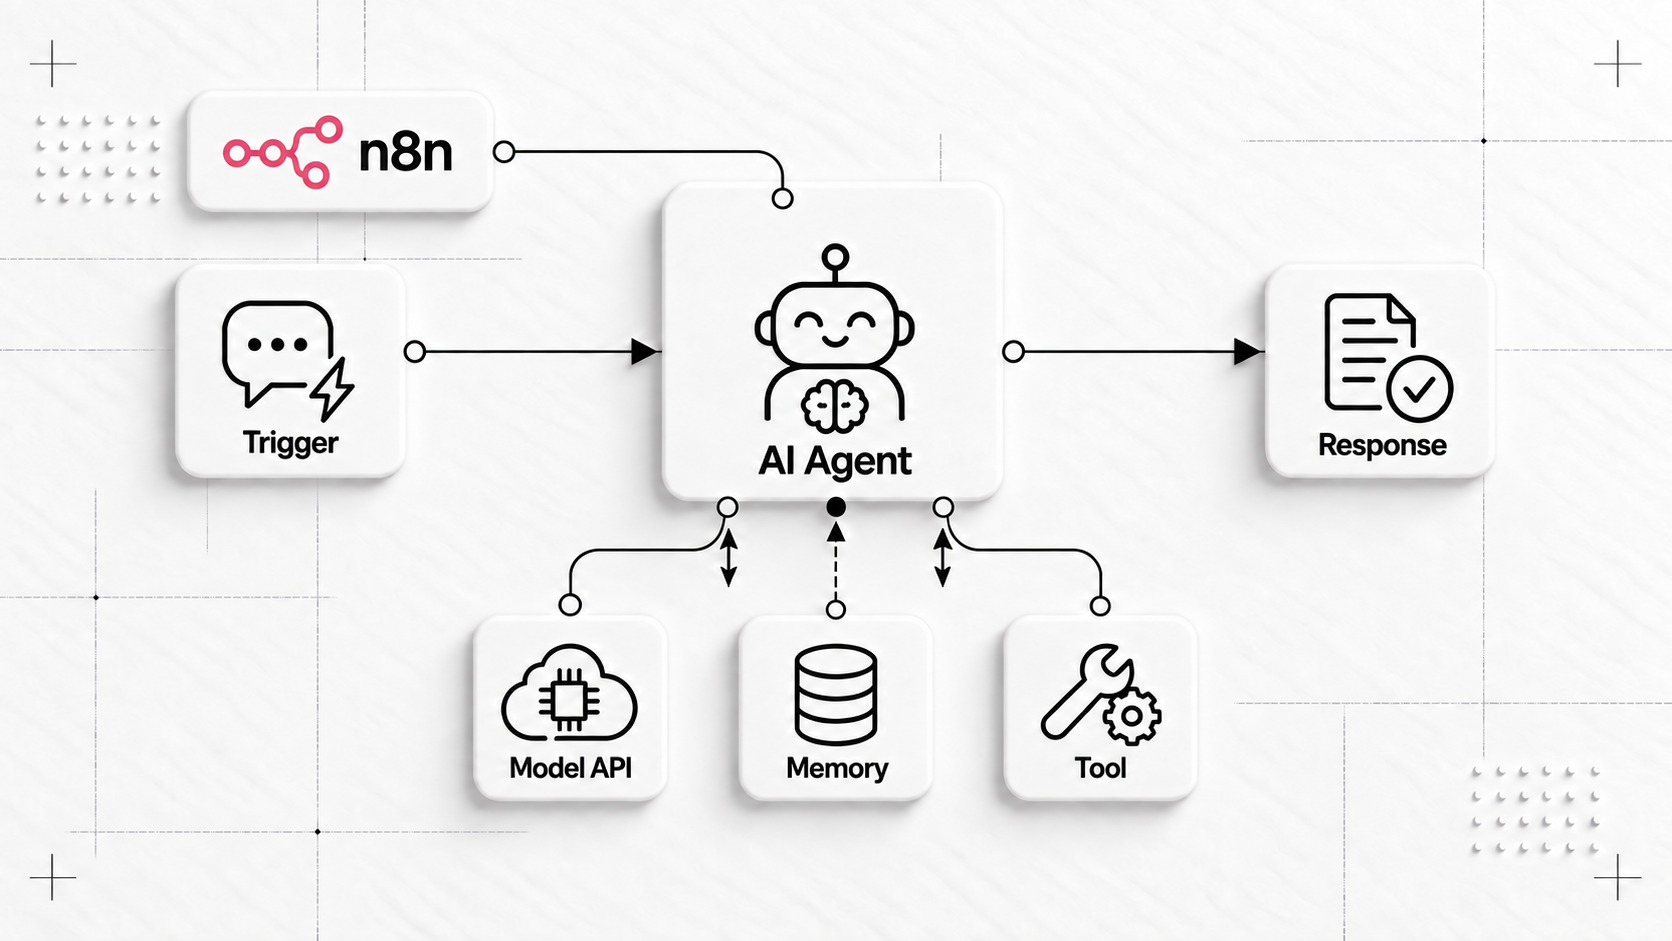
Node مربوط به AI Agent را به Trigger وصل کنید و در System Prompt نقش، داده مجاز و شرایط توقف را بنویسید. یک OpenAI Chat Model به ورودی مدل Agent وصل کنید و کلید پاستا و آدرس پایه https://console.paasta.cloud/api/ai/v1 را در تنظیمات اتصال سازگار با OpenAI نسخه نصبشده قرار دهید. مدل منتخب باید فراخوانی ابزار را پشتیبانی کند. برای مسیر این آموزش، گزینه Use Responses API را خاموش نگه دارید تا از Chat Completions استفاده شود؛ پشتیبانی از یک مسیر به معنی پشتیبانی از همه ابزارهای داخلی Responses نیست.
نمونه JSON زیر فقط آزمایش یک درخواست مدل است، نه یک ایجنت کامل. HTTP Request معمولی جایگزین ورودی Chat Model در AI Agent نیست. اگر نسخه نصبشده اتصال سازگار را ارائه نمیکند، ابتدا مستندات همان نسخه و امکان ارتقای آزمایششده را بررسی کنید؛ ساخت حلقه ابزار بهصورت دستی به پیادهسازی جداگانه نیاز دارد. مرجع تنظیمات: مستندات رسمی OpenAI Chat Model.
{
  "model": "MODEL_ID",
  "messages": [
    {"role": "system", "content": "فقط درباره سفارش آزمایشی پاسخ بده و هیچ تغییری را بدون تایید اجرا نکن."},
    {"role": "user", "content": "{{$json.chatInput}}"}
  ]
}
Header احراز هویت باید Authorization: Bearer PAASTA_API_KEY و نوع محتوا application/json باشد. مقدار کلید را از Credential بخوانید، نه از متن ثابت Workflow.
مرحله پنجم: یک ابزار محدود به Agent بدهید
برای شروع ابزار فقطخواندنی انتخاب کنید؛ مثلاً دریافت وضعیت سفارش آزمایشی. توضیح Tool باید مشخص کند چه زمانی فراخوانی شود، چه ورودیای میگیرد و چه خروجیای برمیگرداند. دسترسی کلی به دیتابیس یا فرمان سیستم برای اولین Agent انتخاب امنی نیست.
پس از اینکه رفتار خواندنی پایدار شد، اقدام تغییردهنده را در یک Workflow جدا قرار دهید و پیش از اجرا تأیید انسان بگیرید. خود Agent نباید بتواند محدودیت یا مرحله تأیید را دور بزند.
مرحله ششم: حافظه را فقط در صورت نیاز اضافه کنید
برای یک پرسش مستقل حافظه لازم نیست. در گفتوگوی چندمرحلهای میتوانید Memory را با شناسه Session متصل کنید، اما زمان نگهداری و اطلاعات مجاز را محدود کنید. Secret، رمز، اطلاعات بانکی یا داده غیرضروری مشتری را وارد حافظه نکنید.
مرحله هفتم: تست، انتشار و کنترل هزینه
- یک درخواست ساده بدون ابزار اجرا و پاسخ مدل را بررسی کنید.
- درخواست دوم را طوری بنویسید که Tool خواندنی فراخوانی شود.
- ورودی نامعتبر، پاسخ خالی API و رسیدن به Rate Limit را آزمایش کنید.
- Execution Log را بررسی کنید، اما ذخیره داده حساس را خاموش یا کوتاهمدت کنید.
- پس از مشاهده مصرف واقعی، سقف کلید را فقط به اندازه لازم افزایش دهید.
هزینه Agent فقط یک پاسخ نیست؛ هر مرحله تصمیمگیری یا فراخوانی دوباره مدل میتواند توکن مصرف کند. Prompt کوتاه، ابزارهای محدود، Context تمیز و مدل متناسب معمولاً اثر بیشتری از انتخاب صرفاً ارزانترین مدل دارند.
معماری پیشنهادی برای نسخه واقعی
مسیر مطمئن شامل Trigger، اعتبارسنجی ورودی، Agent، ابزارهای محدود، مرحله تأیید برای عملیات حساس و پاسخ نهایی است. برای خطا هم شاخه جدا بسازید تا Timeout یا پاسخ نامعتبر به پیام قابل اقدام تبدیل شود و Workflow بینهایت تکرار نشود.
هاست n8n و API هوش مصنوعی دو هزینه جدا دارند
منابع اجرای n8n شامل CPU، حافظه، Volume و دیتابیس است؛ مصرف مدل بر اساس توکن ورودی و خروجی محاسبه میشود. در صفحه هاست n8n منابع اجرای Workflow و در صفحه API هوش مصنوعی پاستا مدل، قیمت و سقف مصرف هر کلید را جدا انتخاب کنید.
جمعبندی
n8n اجرای Workflow، اتصال ابزارها و مشاهده هر مرحله را فراهم میکند؛ اما AI Agent برای فهم و تصمیمگیری به API مدل نیاز دارد. ترکیب هاست n8n با API پاستا، استقرار Workflow و خرید API هوش مصنوعی را در دو مسیر روشن نگه میدارد: منابع n8n جدا، مدل و مصرف API نیز جدا و قابل کنترل.
هاست آماده n8n یا VPS؟
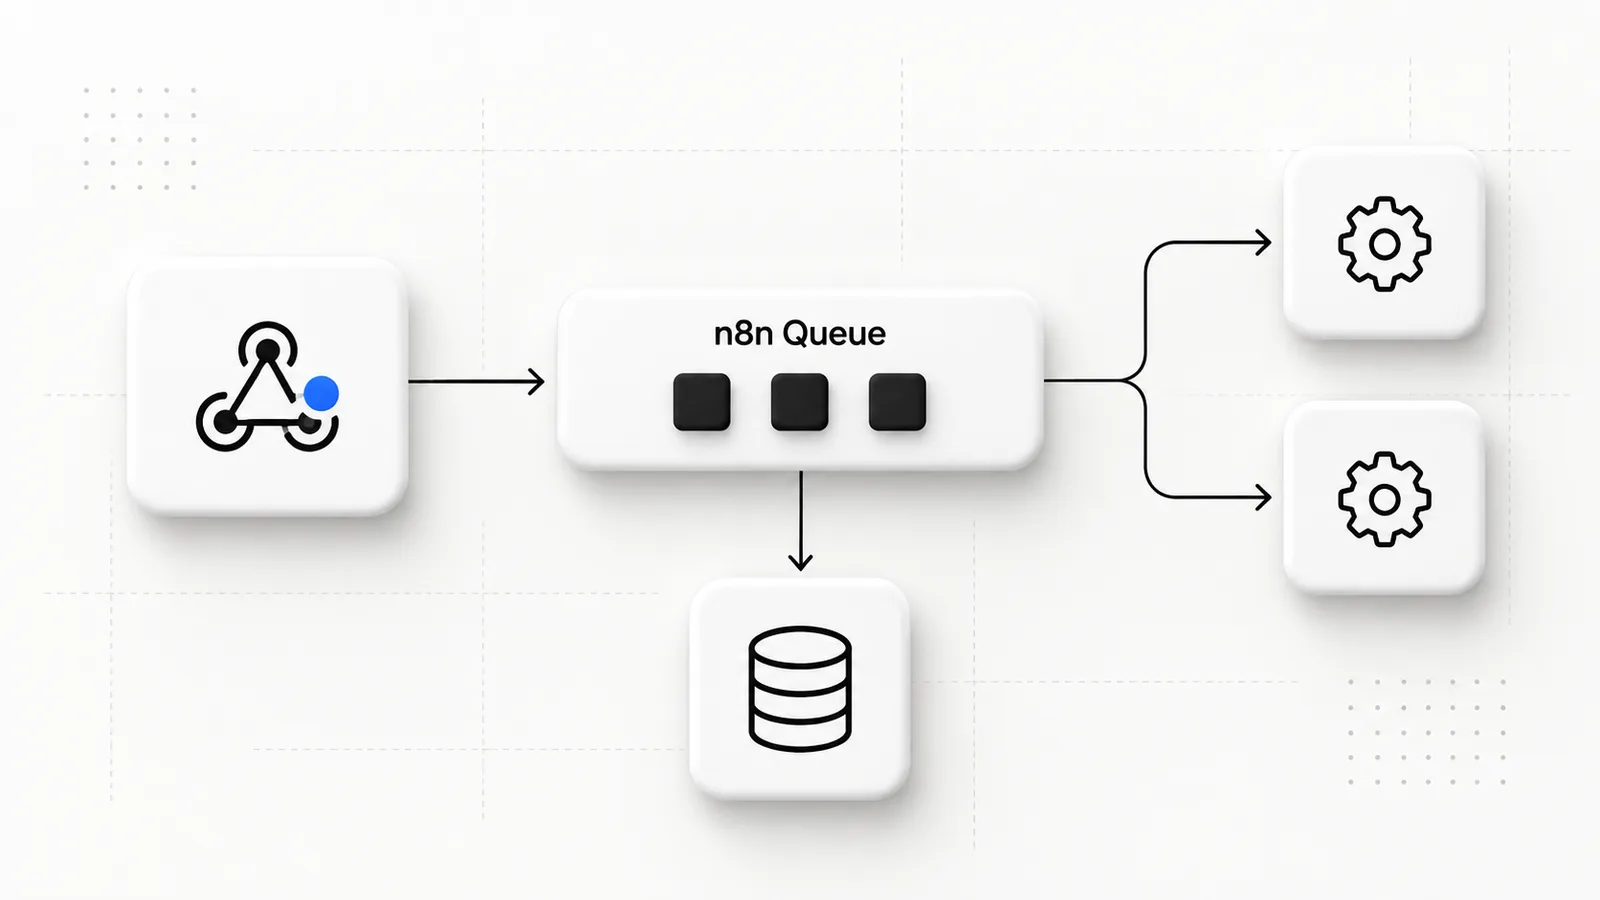
هزینه CPU، حافظه، Volume و PostgreSQL، معماری Queue Mode و تفاوت نگهداری روی VPS را در صفحه خرید هاست n8n در ایران مقایسه کنید.
Agents API یا ایجنت خودمیزبان؟
اگر میان سرویس مدیریتشده OpenAI و اجرای Agent خودتان مردد هستید، راهنمای تفاوت Agents API، Agents SDK و API مدل را بخوانید.
برای تصمیمگیری داخل Workflow چه مدلی مناسب است؟
اگر ایجنت شما باید تیکتها را دستهبندی یا از میان چند مسیر مشخص انتخاب کند، راهنمای Jev و API تصمیمگیری پاستا را ببینید. این مدل برای تصمیم ساختاریافته است، نه تولید متن گفتگو.
شروع با API هوش مصنوعی رایگان پاستا
برای آزمایش اتصال این راهنما میتوانید یک مدل را از فهرست API هوش مصنوعی رایگان پاستا انتخاب کنید. کلید را به مدلهای رایگان محدود و سقف هزینه روزانه و ماهانه را صفر تنظیم کنید؛ سپس شناسه کامل همان مدل را در تنظیمات اتصال قرار دهید. این درخواستها به شارژ کیف پول نیاز ندارند، اما سهمیه فضای کاری و ظرفیت مدل محدود است.
برای Agent و ابزار کدنویسی، مدل باید از فراخوانی ابزار پشتیبانی کند؛ مدل رایگان صرفاً متنی برای همه مراحل Agent کافی نیست. ابتدا یک درخواست کوچک را اجرا و نتیجه را در Playground و گزارش مصرف بررسی کنید. با پایان سهمیه، مدل پولی خودکار جایگزین نمیشود. حساب یا اشتراک ابزار و هزینه میزبانی ربات جداست. برای انتخاب مدلهای بیشتر و مقایسه تعرفه، قیمت و خرید API هوش مصنوعی پاستا را بررسی کنید.
انتخاب API مناسب برای ایجنت
فقط قیمت یک درخواست را مقایسه نکنید؛ مدل باید ابزارهای لازم را پشتیبانی کند و مجموع هزینه مراحل یک کار در بودجه شما بگنجد. برای بررسی معیارها، مقایسه ارائهدهندگان API هوش مصنوعی در ایران را مطالعه کنید. این راهنما هزینه، امنیت و روش آزمایش پاستا، AvalAI و لیارا را توضیح میدهد.

نظرات کاربران (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.