در این مقاله
Hyperresearch ابزاری برای پژوهش با هوش مصنوعی و پاسخ مبتنی بر شواهد است. مسئلهای که دنبال میکند فقط نوشتن متن طولانی نیست: یک پاسخ پژوهشی باید نشان دهد هر ادعا به چه منبعی متکی است، کدام بخش منبع آن را پشتیبانی میکند و کجا هنوز عدم قطعیت وجود دارد. برای تیم محصول، تحلیل بازار یا تولید محتوای فنی، این تفاوت تعیینکننده است. متنی که روان نوشته شده ولی ادعاهایش قابل بررسی نیستند، هنوز گزارش قابل اتکا محسوب نمیشود.
بررسی در ۳ نوامبر ۲۰۲۶: این راهنما بر وبسایت و مستندات رسمی Hyperresearch تکیه دارد. اجرای پژوهش هزینهدار، اتصال حساب و آزمایش انتهابهانتهای API این سرویس انجام نشده است. مثال گردش کار و قرارداد داده پایین، طراحی آموزشی خود مقاله است. ادعاهای بنچمارک فروشنده را نتیجه مستقل نمیدانیم و توجه تازه به ابزار را معادل تاریخ تولد محصول معرفی نمیکنیم.
Hyperresearch چیست و چه خروجیای میخواهیم؟
در معرفی رسمی، پژوهش، منابع، بخشهای پشتیبان، بررسی استناد، فضای نگهداری نتیجه و دسترسی از API و MCP مطرح شدهاند. این اجزا به ما کمک میکنند سؤال را به یک خروجی قابل بازبینی تبدیل کنیم. با این حال، وجود لینک کنار متن کافی نیست؛ ممکن است لینک واقعی باشد ولی ادعای نوشتهشده را پشتیبانی نکند. خروجی مطلوب باید ادعا، منبع و توضیح ارتباط میان آنها را کنار هم نگه دارد.
مثلاً در پژوهش «کدام روش استقرار برای برنامه کوچک ما مناسب است؟» باید نسخه، تاریخ، محدودیت پلن و نیاز واقعی برنامه مشخص باشند. صفحه عمومی قیمت یک ارائهدهنده لزوماً مدرک قابلیت یک پلن قدیمی نیست. گزارش خوب این تفاوتها را حفظ میکند و سؤالهای بیپاسخ را بهجای حدسزدن فهرست میکند. برای شناخت زمینه، معرفی رسمی Hyperresearch نقطه شروع است.
تفاوت با چتبات، جستوجوی وب و RAG
چتبات ممکن است از دانش مدل یا ابزارهای متصل پاسخ بسازد. جستوجوی وب فهرستی از نتایج میدهد. RAG اسناد مشخصی را بازیابی و به مدل ارائه میکند. گردش پژوهش میتواند هر سه را کنار هم قرار دهد، اما به برنامهریزی سؤال، ارزیابی منبع، رفع تناقض و ثبت شواهد هم نیاز دارد. اسم محصول بهتنهایی تضمین نمیکند همه این مراحل برای هر سؤال با کیفیت یکسان انجام میشوند.
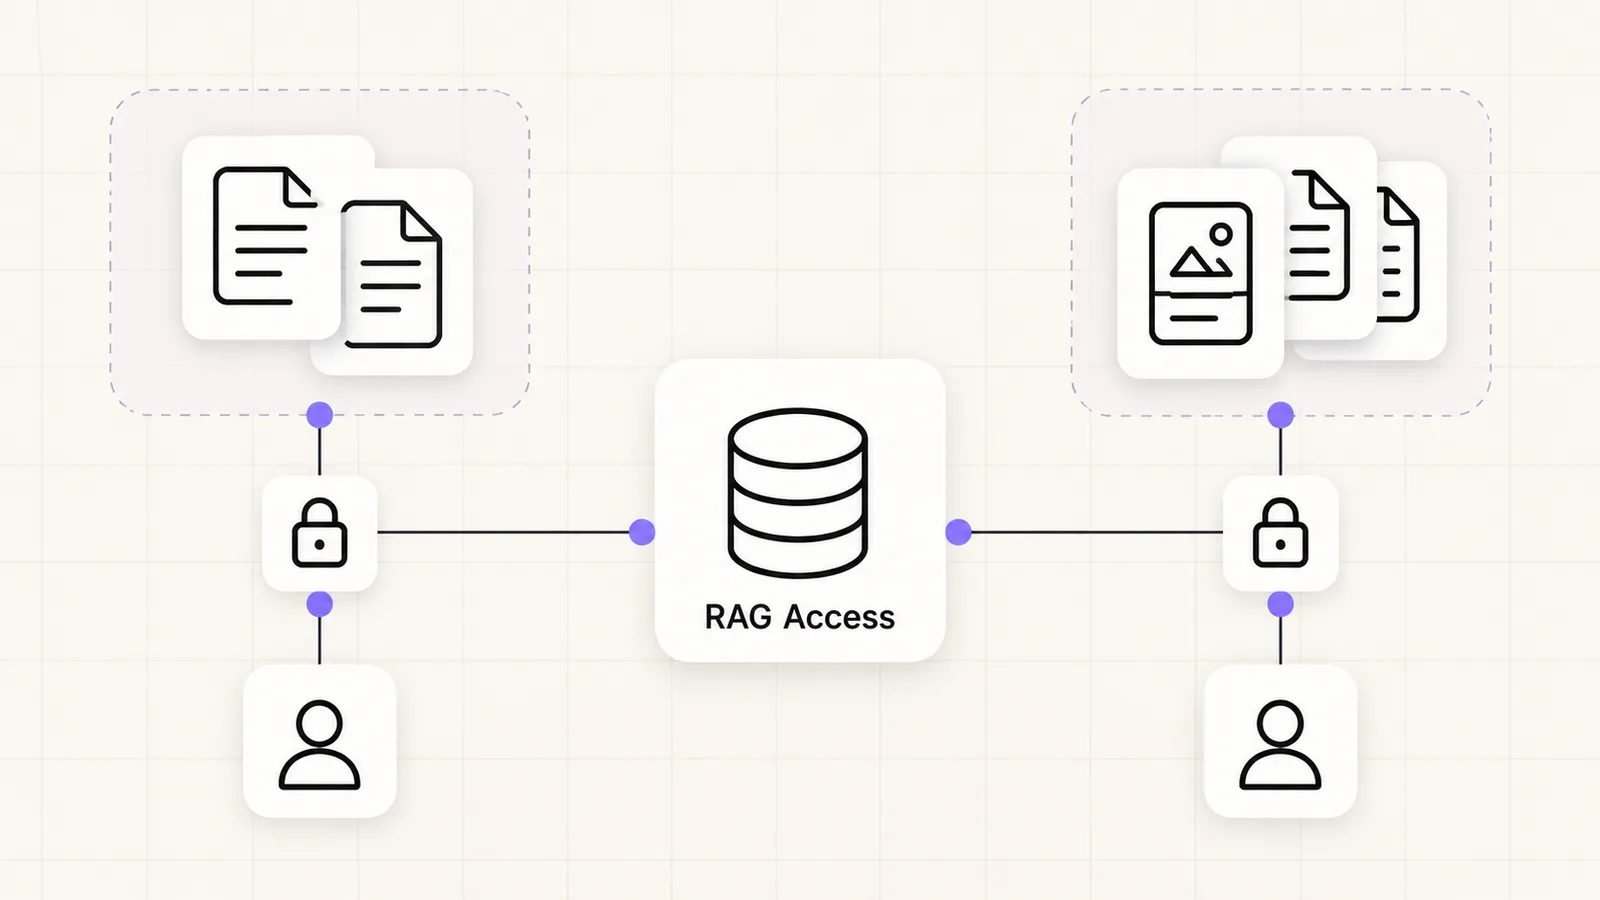
اگر مسئله شما پاسخگویی از اسناد داخلی است، ابتدا راهنمای RAG و Embedding را بررسی کنید. اگر به بررسی منابع عمومی و تولید گزارش نیاز دارید، Hyperresearch میتواند گزینه ارزیابی باشد. برای اسناد چند مشتری، کنترل دسترسی مستقل لازم است؛ مجوز سند در RAG چندمستاجری توضیح میدهد چرا بازیابی مرتبط، جای اجازه مشاهده را نمیگیرد.
پیش از اجرا، سؤال و معیار پایان را محدود کنید
سؤال «آینده هوش مصنوعی چیست؟» دامنه قابل کنترل ندارد. بهجای آن بپرسید: «برای یک تیم سهنفره با برنامه Next.js و دیتابیس مشخص، دو مسیر استقرار را بر اساس هزینه، دسترسی مخاطب ایرانی و مسئولیت نگهداری مقایسه کن؛ فقط مستندات رسمی قابل دسترسی امروز را مبنا قرار بده». این درخواست هم مخاطب دارد، هم محدوده و هم نوع منبع. نتیجه نیز باید فرضها و موارد بررسینشده را جدا بیان کند.
برای پایان، خروجی مشخص تعیین کنید: یک جدول، چند توصیه با شاهد و فهرست سؤالهای باز. تعداد منبع هدف کیفیت نیست؛ ده صفحه کپیشده از یک خبر، ده شاهد مستقل نیستند. تاریخ گردآوری را ثبت کنید و موضوعات متغیر مانند قیمت و نسخه را از اصول ثابت معماری جدا نگه دارید. اگر تاریخ خود منبع نامعلوم است، آن را پنهان نکنید و تاریخ مشاهده را جای تاریخ انتشار ننویسید.
شروع از رابط و بازبینی یک پژوهش محدود
اولین آزمایش را از مسیر رسمی محصول با یک سؤال عمومی بدون اطلاعات خصوصی انجام دهید. قبل از ساخت حساب، شرایط استفاده، هزینه و دسترسی منطقهای را بررسی کنید. سپس خروجی را دستی بخوانید و برای چند ادعای مهم، خود صفحه منبع را باز کنید. آیا نقل مفهوم درست است؟ آیا نتیجه از یک تیتر استخراج شده یا از متن کامل؟ آیا منبع درباره نسخه فعلی صحبت میکند؟ این بررسی کوچک، کیفیت واقعی را بهتر از ظاهر گزارش نشان میدهد.
اگر ابزار برای روشنشدن درخواست سؤال میپرسد، پاسخ باید دامنه را دقیقتر کند. اگر سؤال اشتباه را با جزئیات زیاد پاسخ دهد، طول گزارش آن را درست نمیکند. برای پروژه تیمی، نسخه اولیه پرسش و پاسخهای روشنسازی را همراه نتیجه نگه دارید. بعداً باید معلوم باشد گزارش بر چه فرضهایی نوشته شده و چرا یک گزینه انتخاب شده است. حافظه گفتوگو جای سابقه تصمیم قابل پیگیری نیست.

نظرات کاربران (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.