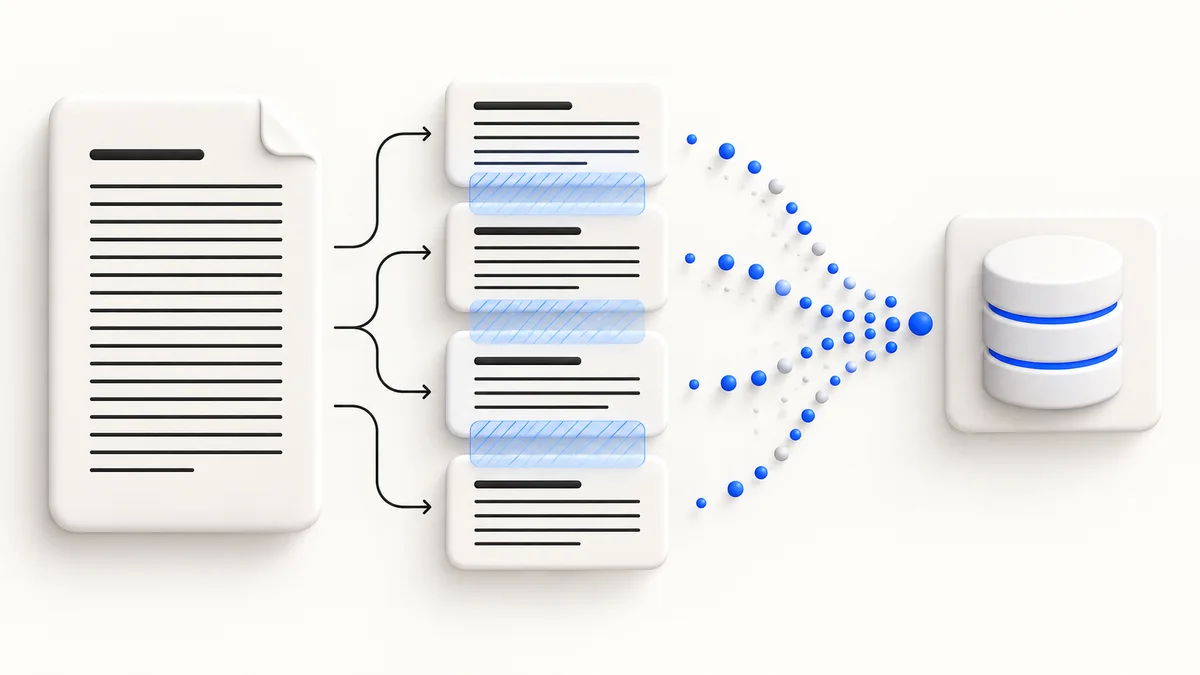
Chunking در RAG یعنی تقسیم سند به بخشهایی که هرکدام بهتنهایی برای بازیابی و پاسخگویی معنا داشته باشند. Chunk خیلی بزرگ متن نامرتبط را وارد Context میکند؛ Chunk خیلی کوچک رابطه جملهها را از بین میبرد. عدد ثابت و جهانی وجود ندارد.
هدف این نیست که سند فقط به قطعههای هماندازه بریده شود. هر Chunk باید یک واحد قابل استناد با عنوان، منبع و جایگاه روشن باشد. بعد از آن میتوان با Embedding API پاستا بردار هر بخش را ساخت.
Chunk مناسب چه ویژگیهایی دارد؟
- موضوع اصلی آن بدون خواندن بخش قبلی قابل فهم است؛
- پاسخ یک سؤال معمول را کامل نگه میدارد؛
- عنوان و Metadata سند را همراه دارد؛
- از سقف ورودی مدل Embedding و Context عبور نمیکند؛
- برای Citation به صفحه یا بخش اصلی قابل نگاشت است.
اندازه Chunk را از کجا شروع کنیم؟
برای متن عمومی، ۳۰۰ تا ۸۰۰ توکن نقطه شروع معقولی است، نه قانون. FAQ کوتاه، قرارداد حقوقی، جدول قیمت و مستند فنی ساختارهای متفاوتی دارند. سه اندازه را روی سؤالهای واقعی مقایسه کنید و Recall بازیابی را بسنجید.
اندازه را با کاراکتر تخمین نزنید اگر کتابخانه Tokenizer مدل در دسترس است. طول یکسان کاراکتر در فارسی و انگلیسی لزوماً تعداد توکن یکسانی ندارد.
همپوشانی Chunk چه زمانی لازم است؟
Overlap بخشی از انتهای Chunk قبلی را در ابتدای Chunk بعدی تکرار میکند تا جمله یا تعریف روی مرز قطع نشود. همپوشانی ۱۰ تا ۲۰ درصدی نقطه شروع رایجی است. مقدار زیاد، هزینه Embedding و نتایج تکراری را بالا میبرد.
اگر برش روی مرز عنوان و پاراگراف انجام شود، معمولاً به همپوشانی کمتری نیاز دارید. اول ساختار را حفظ کنید، بعد برای مرزهای ناگزیر Overlap اضافه کنید.
Chunking معنایی یا ثابت؟
| روش | مزیت | محدودیت |
|---|---|---|
| طول ثابت | ساده و قابل پیشبینی | ممکن است جمله یا جدول را قطع کند |
| پاراگراف و عنوان | ساختار سند را حفظ میکند | طول بخشها یکسان نیست |
| Semantic chunking | تغییر موضوع را تشخیص میدهد | هزینه و پیچیدگی بیشتر دارد |
| ساختار اختصاصی | برای FAQ، کاتالوگ و کد دقیقتر است | برای هر نوع سند Parser جدا میخواهد |