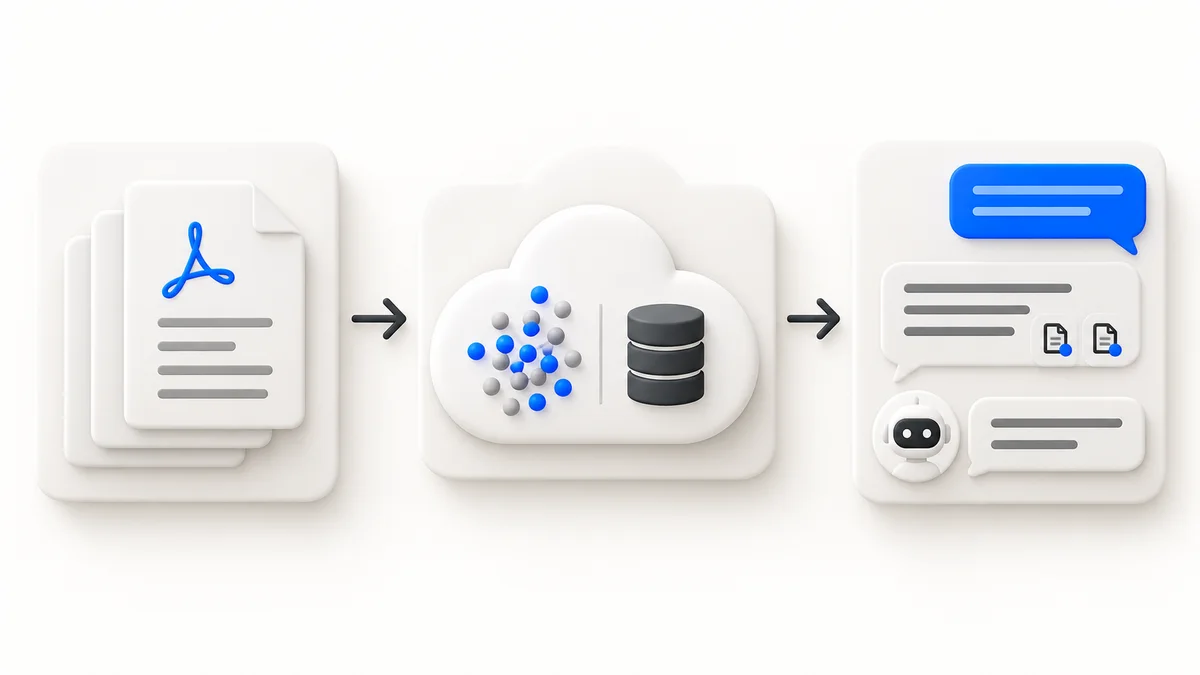
برای ساخت چتبات PDF، متن و شماره صفحه را از فایل استخراج کنید، متن را به Chunkهای قابل بازیابی تقسیم کنید، از هر Chunk یک Embedding بسازید و هنگام سؤال فقط بخشهای مرتبط را به مدل گفتگو بدهید. این معماری RAG است و بدون آموزش دوباره مدل، فایل تازه را قابل پرسش میکند.
در این آموزش API برنامه را با Node.js میسازیم. API پاستا هم Embedding و هم مدل گفتگو را با یک کلید و قرارداد سازگار با OpenAI در اختیار برنامه میگذارد.
معماری چتبات PDF
- بارگذاری و اعتبارسنجی PDF؛
- استخراج متن به تفکیک صفحه؛
- پاکسازی و Chunking؛
- ساخت Embedding و ذخیره متن، صفحه و بردار؛
- Embedکردن سؤال و بازیابی Chunkهای نزدیک؛
- تولید پاسخ فقط از منابع بازیابیشده؛
- نمایش شماره صفحه و لینک فایل.
PDF متنی را از PDF اسکنشده جدا کنید
کتابخانه استخراج متن روی PDF اسکنشده معمولاً خروجی خالی یا نامفهوم میدهد. اگر صفحه تصویر است، ابتدا OCR لازم دارید. زبان فارسی OCR، چرخش صفحه و کیفیت اسکن را بررسی کنید. فایل رمزدار، بسیار بزرگ یا دارای اسکریپت و پیوست ناشناس را مستقیم پردازش نکنید.
فایل را خارج از مسیر عمومی نگه دارید و محدودیت اندازه، MIME و تعداد صفحه بگذارید. متن استخراجشده داده کاربر است؛ آن را در Log ثبت نکنید.
Metadata صفحه را از دست ندهید
type PdfChunk = {
  documentId: string;
  page: number;
  content: string;
  contentHash: string;
};
شماره صفحه، نام فایل و شناسه سند باید همراه Chunk بماند. اگر متن همه صفحهها را به یک رشته تبدیل کنید، Citation قابل اعتماد نخواهید داشت.
متن PDF را به بردار قابل جستوجو تبدیل کنید.
Embedding و مدل گفتگو را با یک کلید محدود و گزارش مصرف جدا اجرا کنید.