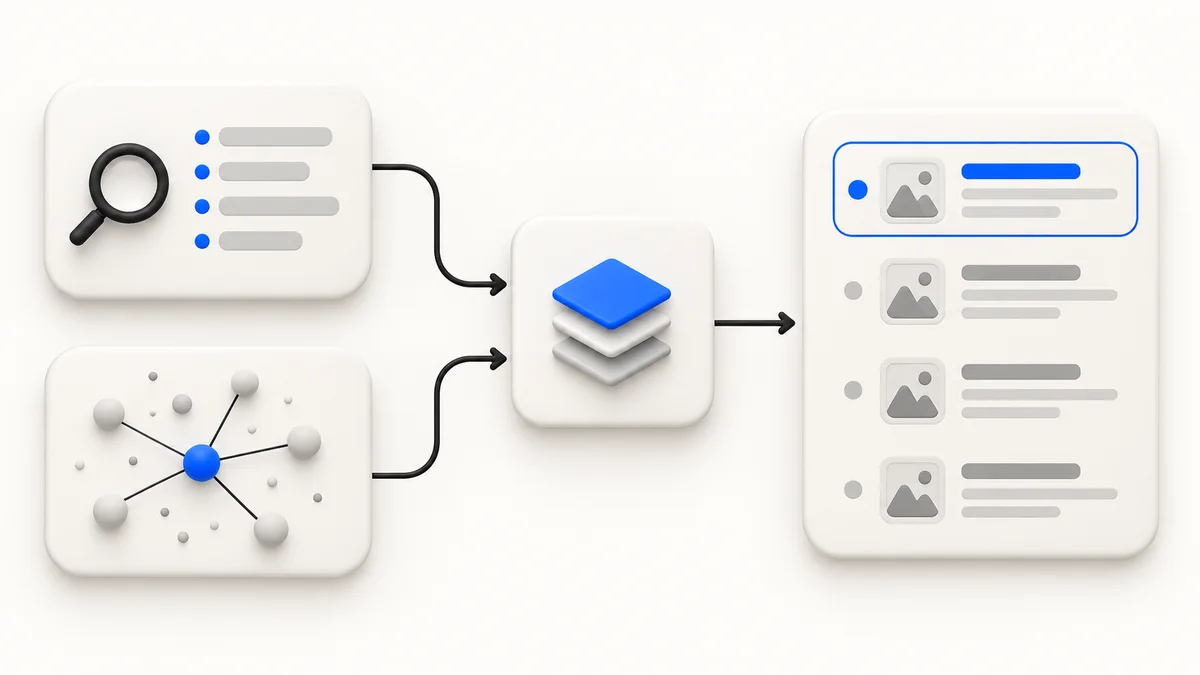
Hybrid Search جستوجوی کلمهای و برداری را همزمان اجرا و رتبههای آنها را ادغام میکند. Vector Search معنی نزدیک را پیدا میکند؛ Full-text برای نام محصول، نسخه، شماره سفارش و کد خطا دقیقتر است. در RAG فارسی معمولاً به هر دو نیاز داریم.
اگر کاربر «هزینه تمدید دامنه» بپرسد، Embedding میتواند متن هممعنا را پیدا کند. اگر «خطای E11000» یا یک شناسه دقیق وارد کند، جستوجوی کلمهای مسیر مطمئنتری دارد.
چرا Vector Search بهتنهایی کافی نیست؟
بردارها شباهت معنایی را فشرده میکنند و ممکن است تفاوت یک عدد، نسخه یا نام کوتاه را کماهمیت ببینند. عبارتهای کمیاب هم همیشه در فضای معنایی جای روشنی ندارند. در مقابل، Full-text مترادف و بیان متفاوت را از دست میدهد.
معماری Hybrid Search
- سؤال را با همان مدل اسناد Embed کنید.
- Vector Search نزدیکترین Chunkها را برگرداند.
- Full-text یا BM25 نتیجههای واژهای را برگرداند.
- فیلتر Tenant، نوع سند و دسترسی روی هر دو مسیر اعمال شود.
- رتبهها با RRF یا وزندهی ادغام شوند.
- در صورت نیاز Reranker روی فهرست کوتاه اجرا شود.
Reciprocal Rank Fusion چیست؟
RRF بهجای مقایسه امتیازهای ناسازگار، جایگاه نتیجه را در هر فهرست میسنجد. نتیجهای که در هر دو مسیر رتبه خوبی دارد بالاتر میآید.
score(document) = Σ 1 / (k + rank(document))مقدار k اثر رتبههای اول را کنترل میکند. آن را با مجموعه Eval تنظیم کنید؛ عدد نمونه را قانون ندانید.
مسیر برداری Hybrid Search را با API پاستا بسازید.
سؤال و سند را با یک مدل ثابت بردارسازی و مصرف هر درخواست را کنترل کنید.
نمونه Query در PostgreSQL
WITH vector_results AS (
  SELECT id, row_number() OVER (ORDER BY embedding <=> $1::vector) rank
  FROM chunks WHERE tenant_id = $2 LIMIT 30
), text_results AS (
  SELECT id, row_number() OVER (
    ORDER BY ts_rank(search_vector, websearch_to_tsquery('simple', $3)) DESC
  ) rank
  FROM chunks
  WHERE tenant_id = $2 AND search_vector @@ websearch_to_tsquery('simple', $3)
  LIMIT 30
)
SELECT COALESCE(v.id, t.id) id,
       COALESCE(1.0 / (60 + v.rank), 0) + COALESCE(1.0 / (60 + t.rank), 0) score
FROM vector_results v FULL JOIN text_results t ON v.id = t.id
ORDER BY score DESC LIMIT 8;
پیکربندی Full-text فارسی را با داده خود بررسی کنید. Normalization، نیمفاصله و شکلهای مختلف کلمه روی Recall اثر دارند.
Embedding سؤال با API پاستا
const queryVector = await ai.embeddings.create({
  model: process.env.EMBEDDING_MODEL,
  input: question,
});
اسناد و سؤال باید با یک مدل و یک ابعاد ساخته شوند. شناسه مدل را ثابت نگه دارید و تغییر آن را مانند Migration مدیریت کنید.
فیلتر قبل از جستوجو
نوع سند، زبان، تاریخ، محصول و سطح دسترسی را پیش از رتبهبندی محدود کنید. شرط tenant_id باید داخل هر دو Query باشد، نه اینکه پس از ادغام نتایج اعمال شود.
Reranking چه زمانی ارزش دارد؟
Reranker سؤال و متن هر نتیجه را دقیقتر بررسی میکند. آن را روی ۲۰ تا ۵۰ کاندید اجرا کنید، نه کل دیتابیس. اگر RRF کیفیت کافی دارد، افزودن یک مدل دیگر فقط زمان و هزینه را بیشتر میکند.
ارزیابی Hybrid Search
سه نسخه Vector-only، Full-text-only و Hybrid را روی یک Query set ثابت بسنجید. پرسش معنایی، عبارت دقیق، نام محصول، غلط املایی و Query بیپاسخ را جدا گزارش کنید. معیارهای Recall@5، MRR، latency و هزینه برای تصمیم کافیاند.
خطاهای رایج
- جمعکردن مستقیم امتیاز Full-text و Cosine بدون نرمالسازی؛
- اعمال فیلتر امنیتی پس از Retrieval؛
- جستوجوی همهچیز با Vector و نادیدهگرفتن شناسه دقیق؛
- افزودن Reranker پیش از اثبات نیاز؛
- تنظیم وزنها با چند مثال دستی بهجای Eval.
Agent متصل به داده را امن بسازید
برای تحلیل ساختاریافته، راهنمای Data Agent و PostgreSQL و برای کنترل ابزارها، چکلیست امنیت MCP را ببینید.