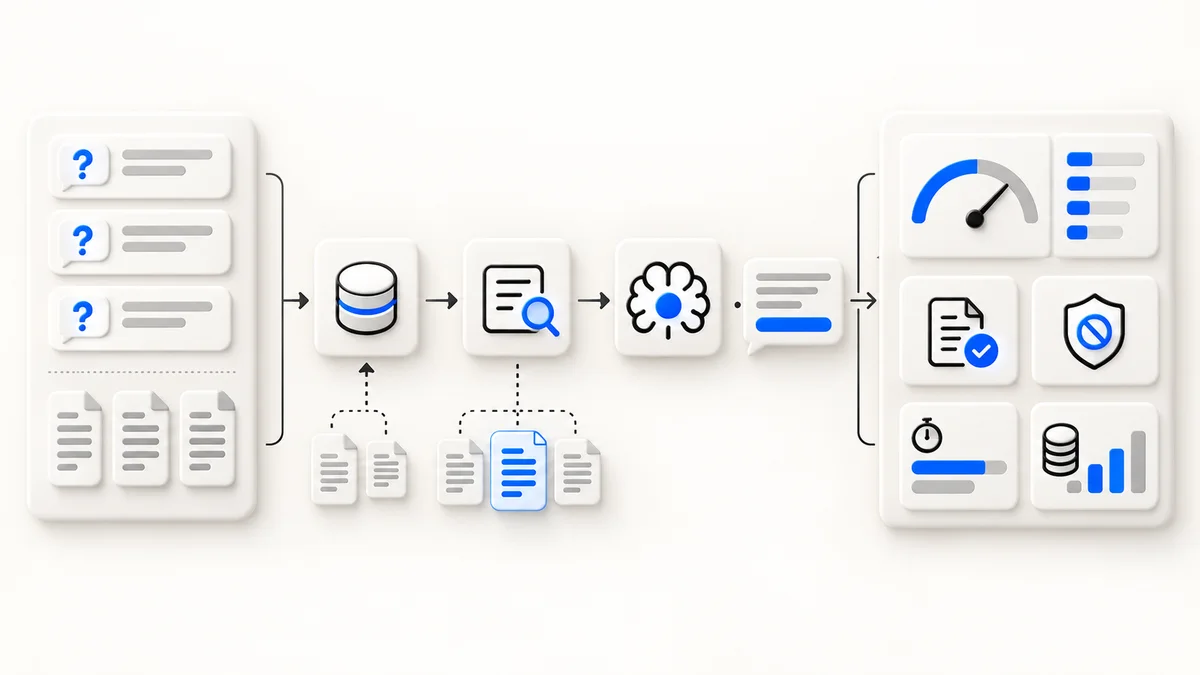
ارزیابی RAG باید Retrieval و Generation را جدا بسنجد. اگر Chunk درست پیدا نشده باشد، مدل پاسخگو نمیتواند مشکل را جبران کند. اگر Chunk درست حاضر است اما پاسخ اشتباه است، باید Prompt یا مدل تولید را بررسی کرد.
یک داشبورد تکامتیازی علت خطا را پنهان میکند. گزارش را به کیفیت بازیابی، پاسخ مستند، امتناع، زمان و هزینه تقسیم کنید.
مجموعه آزمون RAG چگونه ساخته میشود؟
از سؤالهای واقعی Search، پشتیبانی و تیم محصول شروع کنید. برای هر نمونه این موارد را ثبت کنید:
- سؤال کاربر؛
- سند یا Chunk مرتبط؛
- نکتههای لازم در پاسخ؛
- منبع معتبر؛
- اینکه سؤال باید پاسخ داده شود یا رد شود؛
- برچسب نوع Query، مانند معنایی، عبارت دقیق یا چندمرحلهای.
بخشی از داده را برای تنظیم نگه دارید و بخشی را فقط برای آزمون نهایی استفاده کنید. اگر همان مثالها را بارها برای تنظیم Prompt ببینید، نتیجه خوشبینانه میشود.
معیارهای Retrieval
| معیار | معنا |
|---|---|
| Recall@k | وجود حداقل یک Chunk درست در k نتیجه اول |
| MRR | رتبه اولین نتیجه مرتبط |
| Precision@k | سهم نتیجههای مرتبط میان k مورد اول |
| nDCG | کیفیت ترتیب وقتی چند سطح ارتباط داریم |
برای شروع Recall@5 و MRR کافیاند. بعد از تثبیت Dataset، معیار پیچیدهتر اضافه کنید.
معیارهای پاسخ
پاسخ را دستکم از چهار زاویه بررسی کنید: آیا سؤال را جواب داده، آیا هر ادعا از Context پشتیبانی میشود، آیا Citation به Chunk واقعی اشاره میکند و آیا در نبود منبع از حدسزدن خودداری کرده است.
Exact match برای پاسخ فارسی اغلب سختگیرانه است. یک Rubric کوتاه با نکتههای اجباری بسازید و بخشی از نمونهها را انسانی بازبینی کنید. LLM-as-a-judge میتواند کمک کند، اما خودش باید با نمونههای انسانی Calibration شود.
تست سؤال بیپاسخ
حداقل ۲۰ درصد Dataset را به سؤالهایی اختصاص دهید که پاسخشان در اسناد نیست. معیار مهم این است که سامانه صریحاً کمبود منبع را اعلام کند. پاسخ روان اما بیمنبع شکست است.