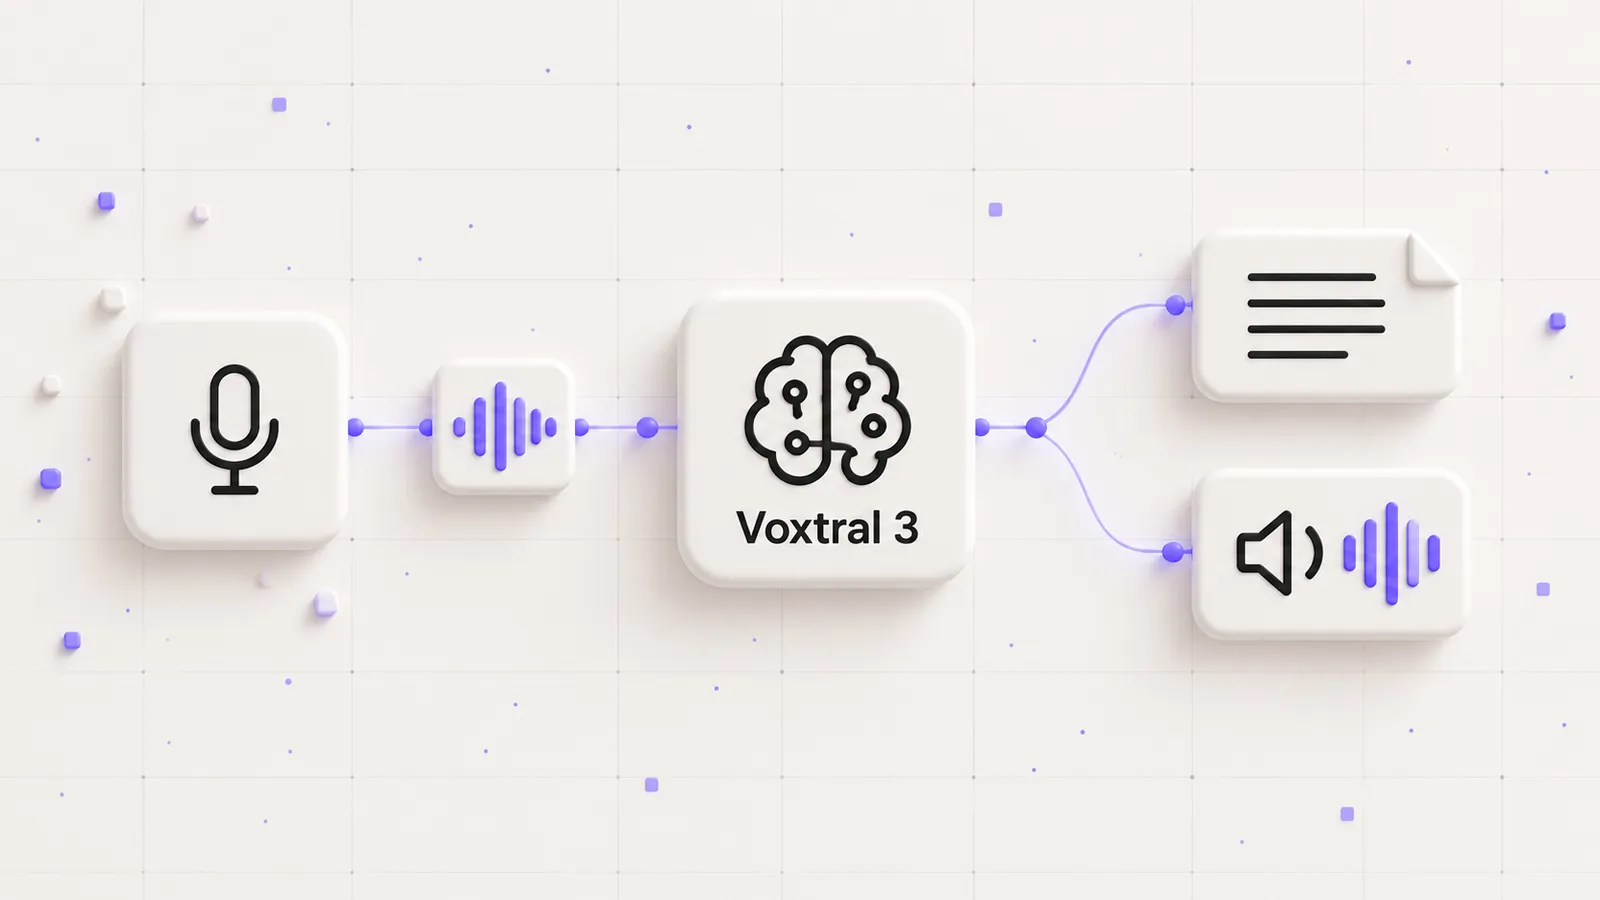
یک دستیار صوتی خوب فقط صدای طبیعی تولید نمیکند. باید حرف کاربر را درست بفهمد، در زمان مناسب پاسخ دهد، هنگام قطع ارتباط رفتار روشن داشته باشد و بدون اجازه کاری انجام ندهد. معرفی Voxtral 3 فرصت خوبی است تا این زنجیره را دقیقتر ببینیم: تبدیل گفتار به متن، تصمیمگیری یا پاسخگویی و تبدیل متن به گفتار. این مقاله برای تیمی نوشته شده که میخواهد از یک نمونه نمایشی به دستیار قابل ارزیابی برسد.
منابع رسمی و کاتالوگ واقعی پاستا در ۲۲ اکتبر ۲۰۲۶ بررسی شدهاند. مدل mistralai/voxtral-mini-tts-3-0:speech در کاتالوگ پاستا فعال، قابل دسترسی از API و دارای قیمت تأییدشده است. این تأیید درباره همین مدل تولید گفتار است، نه همه اعضای خانواده Voxtral 3 یا مکالمه زنده. کیفیت فارسی و استنتاج واقعی صوت در این بررسی آزموده نشدهاند. برای استفاده عملی، وضعیت روز و قابلیت دقیق همان شناسه را دوباره در حساب خود بررسی کنید.
Voxtral 3 چیست و کدام بخش دستیار صوتی را پوشش میدهد؟
در اعلام رسمی Mistral، خانواده تازه گفتاری و مسیر ساخت تجربه صوتی معرفی شده است. اما در طراحی محصول، نام یک خانواده کافی نیست: مدل تبدیل گفتار به متن، مدل تولید صدا و ابزار هماهنگکننده گفتوگو وظایف یکسانی ندارند. ابتدا مشخص کنید کار شما پیادهسازی جلسه، دریافت پیام صوتی، خواندن پاسخ یا گفتوگوی زنده است. سپس قرارداد و مدل مناسب همان کار را بررسی کنید.
برای نمونه، تبدیل یک فایل جلسه به متن نیاز متفاوتی از دستیار تلفنی دارد. در اولی ممکن است دقت نامها و زمانبندی مهمتر از چند ثانیه تأخیر باشد. در دومی، تأخیر، نوبتگیری و قطعکردن صدای پاسخ توسط کاربر حیاتی است. مقایسه این دو با یک معیار کلی «کیفیت صدا» تصمیم را گمراه میکند. محصول را بر اساس مسیر کار تعریف کنید، نه فهرست طولانی قابلیتهای معرفیشده یک مدل.
تفاوت STT، TTS و Realtime را روشن کنیم
STT گفتار را به متن تبدیل میکند و TTS متن را به صدا. گفتوگوی زنده علاوه بر این دو، به انتقال صوت، تشخیص پایان نوبت، مدیریت قطع صحبت و وضعیت نشست نیاز دارد. پاسخ جریانی متن یا دریافت تدریجی فایل صوتی بهتنهایی معادل ارتباط صوتی دوطرفه نیست. اگر این تمایز از ابتدای پروژه روشن نباشد، نمونهای که یک پیام را خوب پاسخ میدهد ممکن است هنگام مکالمه واقعی بهسرعت ناکارآمد شود.
| مسیر | ورودی و خروجی | آزمون مناسب |
|---|---|---|
| پیادهسازی صوت | فایل صوتی به متن | نام، عدد، نفی و سکوت |
| خواندن پاسخ | متن به فایل یا جریان صوت | تلفظ، مکث و شنیداریبودن |
| مکالمه زنده | نشست صوتی دوطرفه | نوبتگیری، قطع صحبت و بازیابی اتصال |
در وضعیت فعلی این راهنما، برای پاستا endpoint عمومی Realtime تأیید نمیکنیم. مسیرهای مستند تبدیل صوت، متن و تولید گفتار را باید با مدل دارای همان قابلیت استفاده کرد. اگر پروژه شما مکالمه زنده میخواهد، این نیاز را صریح بهعنوان بخش جداگانه معماری بررسی کنید. تغییر نام یک route به realtime یا استفاده از WebSocket بهخودیخود امکانات کامل یک سرویس مکالمه صوتی را ایجاد نمیکند.
وضعیت مدلها و محدودیت مهم زبان فارسی
کارت رسمی Voxtral Mini Transcribe 3 و Voxtral TTS 3 هر دو وضعیت Public Preview را نشان میدهند. در کارت TTS، پشتیبانی ۹ زبان ذکر شده، درحالیکه خبر معرفی درباره دامنه گستردهتری صحبت میکند. برای تصمیم اجرایی، قابلیت دقیق همان شناسه و endpoint را مبنا قرار دهید؛ از عنوان چندزبانه نمیتوان پشتیبانی باکیفیت فارسی را نتیجه گرفت.
حتی اگر یک مدل فایل فارسی را بپذیرد، هنوز باید لهجه، نام برند، واحد پول و عدد را بسنجید. «پنجاه هزار» و «پانصد هزار» در پشتیبانی مالی اختلاف کوچکی نیستند. برای تولید صوت نیز شنونده باید متن را بدون نگاهکردن به صفحه بفهمد. پذیرش ورودی فارسی، صحت تشخیص و تلفظ طبیعی سه موضوع جدا هستند. این مقاله هیچ نمره یا ادعای برتری فارسی بدون مجموعه آزمون ارائه نمیکند.
یک سناریوی شروع مناسب: پاسخ به پیام صوتی پشتیبانی
نسخه اول را به دریافت فایل صوتی کوتاه و تولید پاسخ پیشنهادی محدود کنید. کاربر درباره ویژگی عمومی یک محصول میپرسد، فایل به متن تبدیل میشود و متن برای تأیید یا اصلاح نمایش داده میشود. سپس اطلاعات معتبر محصول بازیابی و پاسخ کوتاه ساخته میشود. در پایان، در صورت پشتیبانی مدل انتخابی، پاسخ میتواند به صدا تبدیل شود. این مسیر برای آزمایش سادهتر از پاسخگویی تلفنی زنده است و خطای هر مرحله را آشکار میکند.
در شروع، پرداخت، تغییر سفارش و تأیید هویت را از پاسخ خودکار کنار بگذارید. اگر پیام شامل داده حساس است، به کاربر توضیح دهید چه چیزی پردازش و تا چه زمانی نگهداری میشود. متن پیادهشده را با صوت اصلی یک داده یکسان فرض نکنید؛ هرکدام سیاست نگهداری و مجوز خود را دارند. برای بخش اطلاعات محصول، راهنمای پشتیبان ووکامرس با n8n یک مسیر مکمل برای ارجاع انسانی و پاسخ مبتنی بر منبع ارائه میکند.