در این مقاله
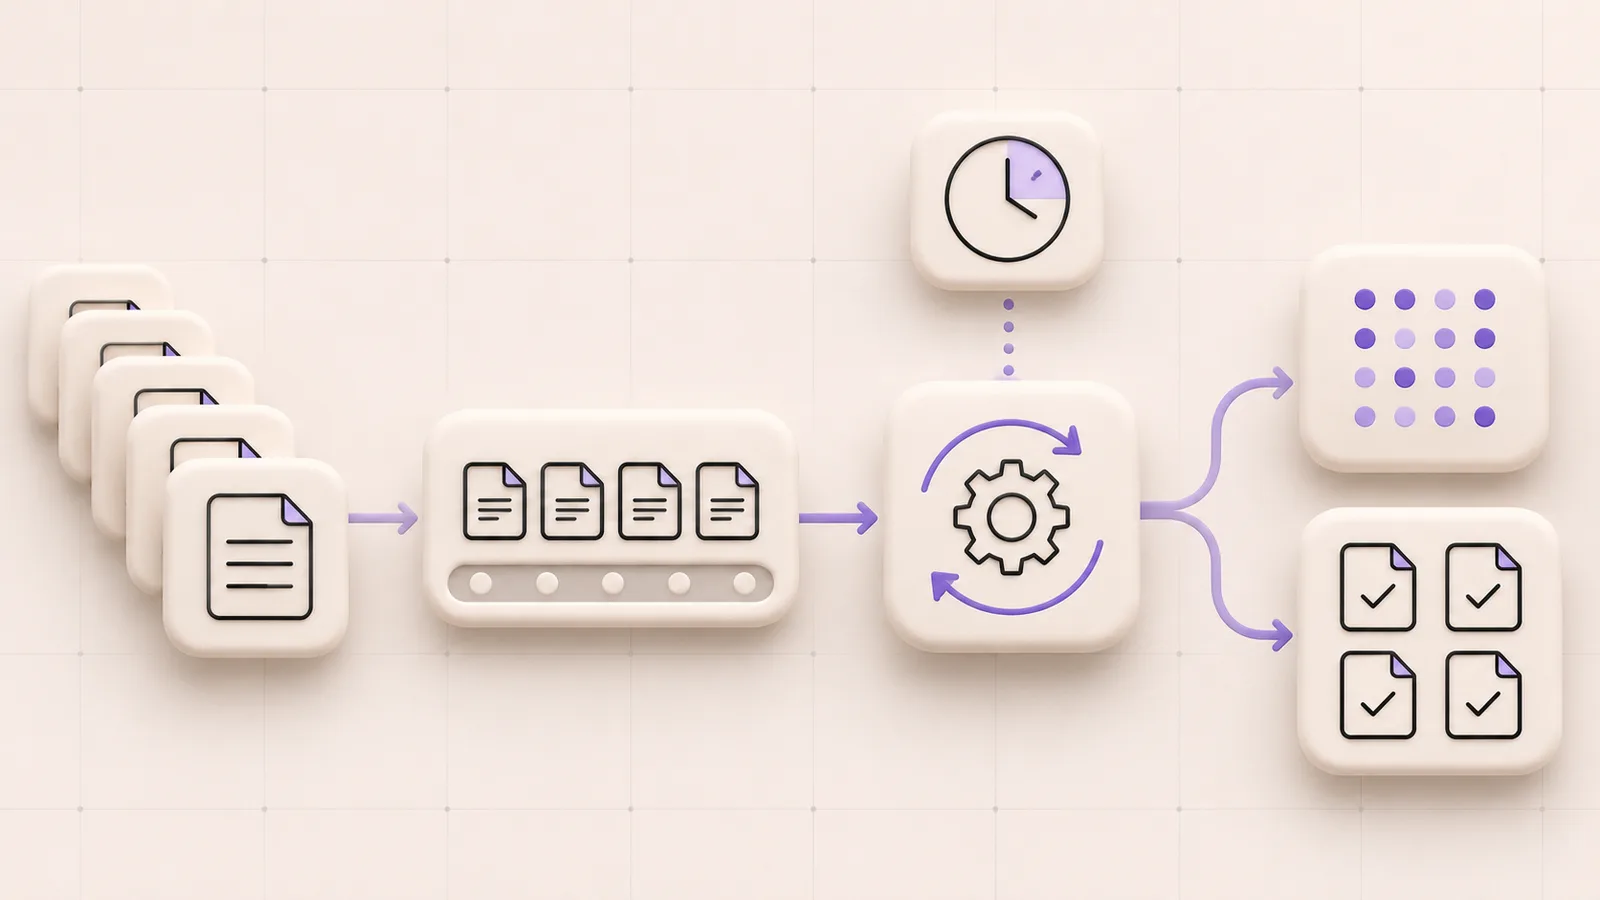
برای خلاصهسازی تعداد زیادی متن یا آمادهکردن اسناد RAG، لازم نیست همه کارها در یک درخواست وب انجام شوند. اما سه مفهوم متفاوت داریم: Batch متنی ارائهدهنده، چند ورودی در یک درخواست Embedding و صفی که خود برنامه اداره میکند. هرکدام قرارداد، سقف و روش بازیابی جداگانه دارند. یکسانفرضکردن آنها میتواند درخواست نامعتبر یا پردازش تکراری بسازد.
این راهنما قرارداد فعلی Batch متنی پاستا و طراحی پردازش گروهی Embedding در برنامه را توضیح میدهد. پشتیبانی Embedding در همان endpoint Batch متنی ادعا نمیشود. نمونهها برای داده ساختگیاند و اجرای استنتاج پولی یا پردازش انبوه واقعی برای این مقاله انجام نشده است.
Batch API چیست و چه زمانی ارزش دارد؟
برای آشنایی با مفهوم پردازش غیرهمزمان، راهنمای رسمی Batch در OpenAI مفید است؛ قرارداد فایل، سقف، زمانبندی و تعرفه آن را به پاستا تعمیم ندهید. مرجع اجرای نمونه این مقاله، مستندات خود پاستاست.
در Batch، مجموعهای از کارها با شناسههای قابل پیگیری ثبت و نتیجه در مرحله بعد دریافت میشود. این الگو برای کاری مناسب است که کاربر لازم نیست پاسخ آن را بلافاصله در گفتوگو ببیند؛ مثل خلاصهسازی شبانه یا پردازش مطالب از قبل موجود.
Batch بهخودیخود به معنی اجرای همزمان نامحدود، تضمین زمان تحویل یا تخفیف ثابت نیست. سرعت، قیمت و قرارداد هر سرویس را باید جدا بررسی کرد. در برنامه نیز وضعیت در حال انتظار با شکست قطعی یا موفقیت فرق دارد و باید به کاربر قابل نمایش باشد.
قرارداد فعلی Batch متنی پاستا
در مستندات فعلی API پاستا، مسیر POST /batches برای یک تا ۲۰ درخواست از یک مدل پشتیبان Batch توضیح داده شده است. هر ردیف custom_id یکتا دارد و سقف خروجی همان ردیف با max_tokens مشخص میشود. برخی مدلها حداقل خروجی مجاز دارند؛ مقدارهای دلخواه بسیار کوچک را معتبر فرض نکنید.
در همین قرارداد، فایل JSONL، استریم، لغو Batch متنی و چند مدل در یک Batch فعال نیستند. نمونههای سرویسهای دیگر را مستقیم به این مسیر نفرستید. مدل را از موجودی و قابلیت همان مسیر انتخاب کنید؛ وجود مدل در چت معمولی، پشتیبانی Batch را ثابت نمیکند.
نمونه بدنه درخواست محدود
در نمونه زیر، MODEL_ID باید با مدل دارای پشتیبانی Batch جایگزین شود. این یک قالب درخواست است و نباید بدون بررسی مدل، قیمت و کلید به تولید فرستاده شود. نشانی کامل مسیر پاستا https://console.paasta.cloud/api/ai/v1/batches است.
{
  "model": "MODEL_ID",
  "endpoint": "/v1/chat/completions",
  "requests": [
    {
      "custom_id": "summary-001",
      "body": {
        "messages": [{"role": "user", "content": "این متن ساختگی را در یک جمله خلاصه کن: فروشگاه امروز ساعات کاری خود را تغییر داد."}],
        "max_tokens": 256
      }
    }
  ]
}
هدر احراز هویت فقط سمت سرور و با کلید پروژه ارسال میشود. برای عملیات، شناسه idempotency ثابت و معنادار تعریف کنید و آن را در تلاشهای مربوط به همان ثبت حفظ کنید. ساختن کلید تازه برای هر timeout، تلاشها را از یک عملیات به چند عملیات مستقل تبدیل میکند.
پیش از ارسال، دفتر ثبت کار بسازید
برای هر ردیف، شناسه سند، نسخه محتوا، نسخه پرامپت، مدل و وضعیت را ثبت کنید. کل متن حساس لازم نیست برای مشاهده وضعیت در جدول عمومی قرار بگیرد. شناسه ردیف باید نتیجه را به ورودی درست وصل کند، حتی اگر ترتیب پاسخها متفاوت باشد.
اگر یک متن تغییر کرده، نتیجه نسخه قبلی نباید روی نسخه جدید نوشته شود. برای پذیرش نتیجه، نسخه ورودی را دوباره بررسی کنید. همین قاعده برای تغییردادن پرامپت یا schema هم لازم است؛ یک شناسه سند ثابت، همه نسخههای پردازش آن سند را یک کار نمیکند.

نظرات کاربران (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.