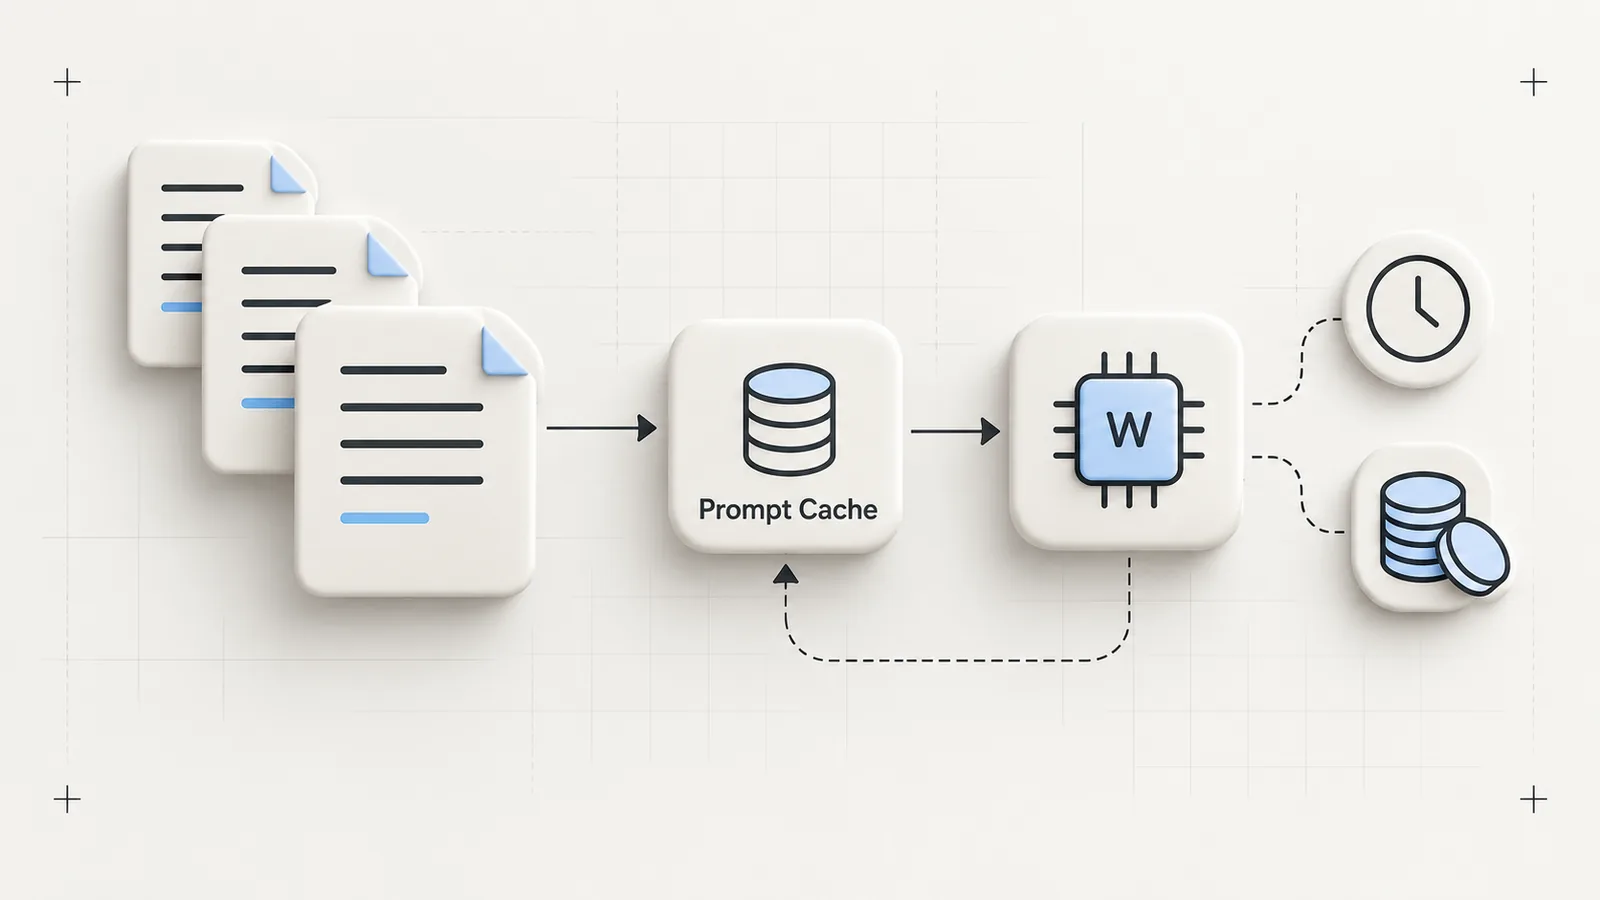
کش پرامپت یا Prompt Caching، امکان استفاده دوباره از محاسبه بخش تکراری ورودی مدل را فراهم میکند. این قابلیت با ذخیره و بازگرداندن پاسخ قبلی فرق دارد. در یک درخواست جدید، مدل هنوز میتواند پاسخ تازه تولید کند، اما لازم نباشد تمام پیشوند مشترک را از ابتدا پردازش کند. میزان صرفهجویی به مدل، مسیر ارائه، طول بخش مشترک و شرایط قیمتگذاری وابسته است.
هدف این راهنما، ساخت یک آزمایش قابل تکرار برای هزینه و تأخیر است. درصد ثابت کاهش هزینه وعده نمیدهیم و پشتیبانی همه مدلهای API هوش مصنوعی پاستا را یکسان فرض نمیکنیم. نتیجه معتبر از usage درخواست و گزارش هزینه همان مسیر به دست میآید، نه از کپیکردن تعرفه یک ارائهدهنده دیگر.
کش پرامپت با کش پاسخ و RAG چه فرقی دارد؟
کش پاسخ، خروجی ذخیرهشده یک سؤال یا کلید مشخص را برمیگرداند. در کش پرامپت، محاسبه ورودی مشترک دوباره استفاده میشود ولی تولید خروجی ادامه دارد. RAG هم اسناد مرتبط را برای پاسخ پیدا میکند. این سه روش میتوانند کنار هم باشند، اما مشکل یکسانی را حل نمیکنند.
| روش | چه چیزی استفاده مجدد میشود؟ | خطر مهم |
|---|---|---|
| کش پاسخ | متن یا نتیجه قبلی | نمایش پاسخ قدیمی یا متعلق به کاربر دیگر |
| کش پرامپت | محاسبه بخش مشترک ورودی | فرض نادرست درباره Hit، تعرفه یا مدت نگهداری |
| RAG | اسناد و بردارهای قابل بازیابی | بازیابی داده نامرتبط یا بدون مجوز |
برای فهم ارتباط بازیابی و ورودی مدل، راهنمای ساخت RAG با Embedding را ببینید. اگر پرسش هر بار سندهای متفاوت میآورد، سهم مشترک پرامپت ممکن است محدود باشد. کش نمیتواند جای انتخاب دقیق سند یا کوتاهکردن Context نامرتبط را بگیرد.
چه بخشی از پرامپت را ثابت نگه داریم؟
دستور نقش، قالب خروجی، تعریف ابزارها و اطلاعات مرجع واقعاً ثابت، نامزدهای طبیعیاند. پرسش جاری، تاریخ متغیر و داده کاربر را تا حد امکان بعد از بخش ثابت قرار دهید. «ثابت» یعنی از نظر محتوای ارسالی واقعاً تغییر نکند، نه اینکه برای انسان تقریباً مشابه به نظر برسد. تغییر ترتیب ابزارها یا افزودن شناسه تصادفی در ابتدای پیام میتواند اشتراک پیشوند را از بین ببرد.
با این حال، برای گرفتن Hit نباید داده لازم را حذف کنید یا قواعد امنیتی را عقب بیندازید. دسترسی کاربر به اسناد همچنان باید قبل از ساخت Context کنترل شود. همچنین هرگونه جداسازی Cache براساس مشتری باید مطابق قرارداد ارائهدهنده و طراحی برنامه باشد؛ یک کلید اشتراک بدون مرز مستأجر برای داده خصوصی قابل قبول نیست.
چرا قابلیت ارائهدهندگان یکسان نیست؟
در مستندات Claude، تنظیم Cache و اطلاعات مصرف مربوط به خواندن یا ایجاد آن توضیح داده شده است. مستندات Gemini نیز شیوههای Context Caching را با قواعد خودش شرح میدهد. این پارامترها را نباید بدون بررسی در یک endpoint سازگار با OpenAI کپی کرد.
یک Gateway ممکن است پارامتر را بپذیرد، تبدیل کند، حذف کند یا برای یک مسیر رد کند. قبولشدن درخواست به معنی اعمال تخفیف نیست. مدل نیز ممکن است حداقل طول یا محدودیت دیگری داشته باشد. بنابراین سه سؤال جدا بپرسید: آیا درخواست معتبر است؟ آیا Cache واقعاً استفاده شده؟ آیا صورتحساب این استفاده را منعکس میکند؟
یک آزمایش منصفانه طراحی کنید
دو مجموعه بسازید: درخواستهایی با پیشوند ثابت و پرسش متفاوت، و درخواستهایی که بخش اولیه آنها عمداً تغییر میکند. مدل، طول پاسخ درخواستی، منطقه اجرا و زمان آزمایش را تا حد امکان یکسان نگه دارید. ابتدا یک اجرای گرمکننده را جدا ثبت کنید و آن را پنهان نکنید؛ هزینه ایجاد Cache بخشی از هزینه کل سناریو است.
برای هر درخواست، زمان شروع، زمان پایان، شناسه مدل، تعداد توکن ورودی و خروجی و هر فیلد Cache ارائهشده را ثبت کنید. در حالت Streaming، زمان اولین بخش پاسخ را از زمان پایان جدا بگیرید. این دو معیار پاسخ دو سؤال متفاوتاند: کاربر چه زمانی چیزی مشاهده میکند و کار کامل چه زمانی تمام میشود؟
تعداد نمونه را آنقدر کم نگیرید که یک تغییر شبکه نتیجه را تعیین کند. چند دور در بازههای متفاوت اجرا کنید و میانه و صدک بالاتر تأخیر را گزارش دهید. برای مقایسه هزینه، کیفیت خروجی را هم ثابت نگه دارید؛ پاسخ ناقص کوتاهتر ممکن است ارزان باشد اما کار را تمام نکند.