در این مقاله
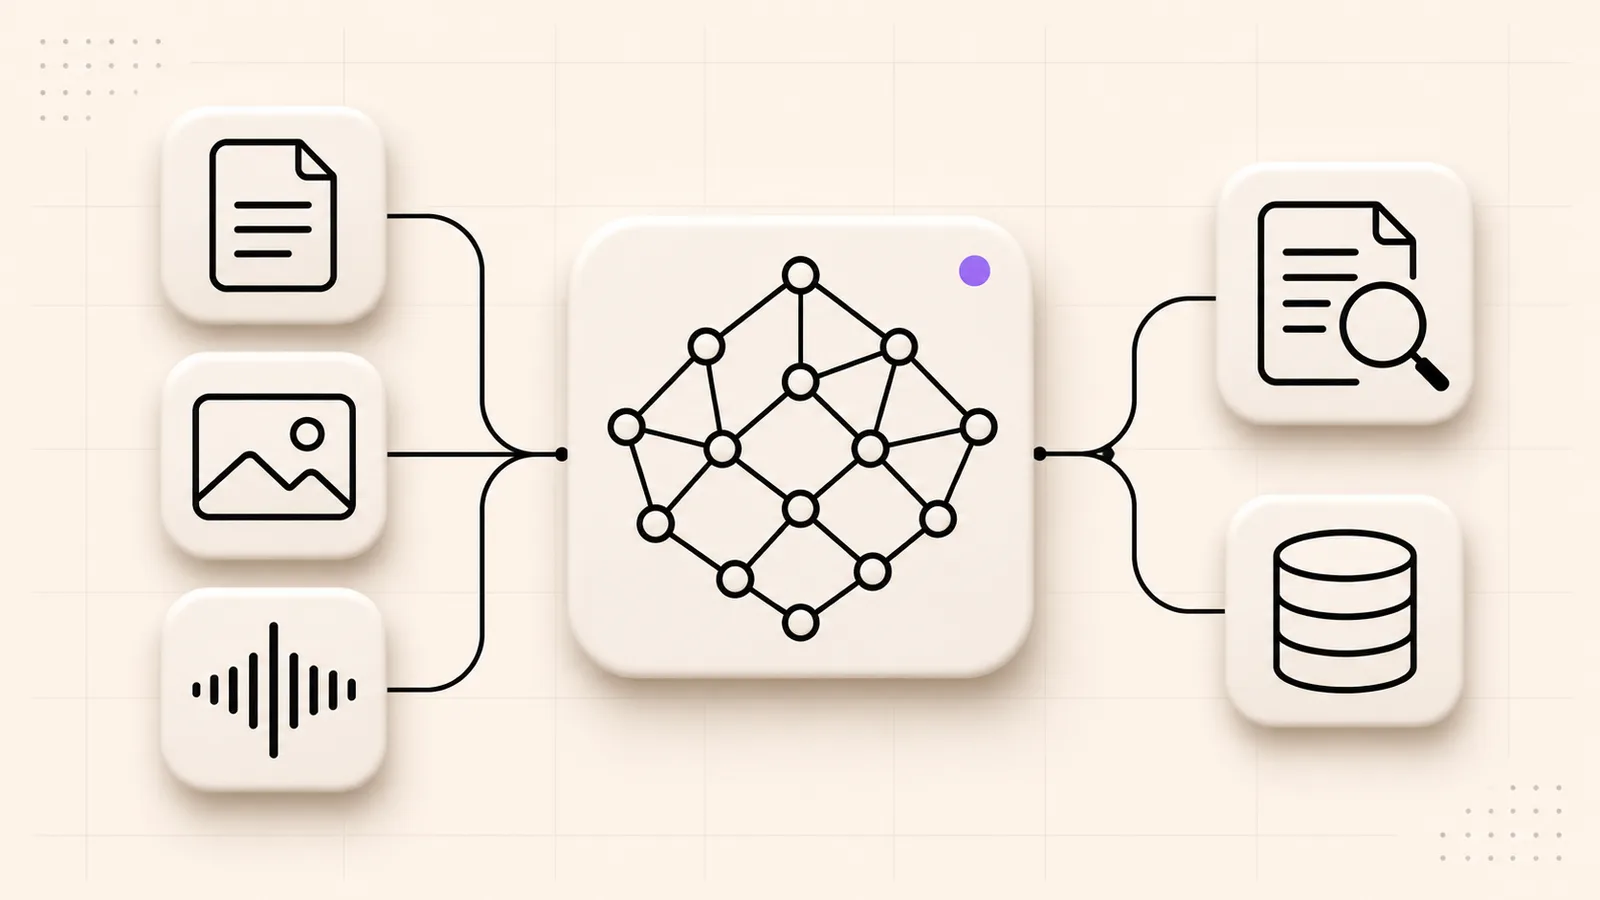
EmbeddingGemma 2 مدل گوگل برای تبدیل متن، کد، تصویر، صدا و ویدئو به بردارهای قابل جستوجو است. کاربرد اصلی آن ساخت پاسخ چت نیست؛ کمک میکند ورودی کاربر را به سند، تصویر یا قطعهای از محتوای مرتبط وصل کنید. اگر کلاستر RAG شما تاکنون فقط متن را جستوجو میکرده، این مدل موضوع مناسبی برای بررسی بازیابی چندرسانهای و جستوجوی محلی است.
در این راهنما یک نمونه کوچک جستوجوی متن فارسی میسازیم، روش گسترش آن به داده چندرسانهای را توضیح میدهیم و معماری اتصال نتیجه به API هوش مصنوعی پاستا را بررسی میکنیم. عرضه EmbeddingGemma 2 در کاتالوگ API پاستا در این مقاله تأیید نشده است؛ اجرای خود مدل، استفاده از مدل embedding موجود در پاستا و تولید پاسخ با مدل زبانی، سه انتخابی هستند که باید آگاهانه کنار هم قرار بگیرند.
EmbeddingGemma 2 چیست و چه چیز تازهای دارد؟
طبق معرفی رسمی گوگل، نسل دوم خانواده EmbeddingGemma ورودیهای چندرسانهای را در یک فضای برداری مشترک نمایش میدهد. کارت مدل EmbeddingGemma 2، معماری ماژولار، بردار خروجی بومی ۷۶۸بعدی و امکان کوتاهکردن بعد را مستند کرده است. این مشخصات را باید با نسخه مدل و کتابخانهای که واقعاً بارگذاری میکنید تطبیق دهید.
تفاوت کاربردی را با یک مثال ببینیم: کاربر میگوید «تصویر محصول آبی با دو درگاه USB را پیدا کن». یک سامانه صرفاً متنی فقط توضیح متنی محصول را میبیند؛ یک طراحی چندرسانهای میتواند محتوای تصویر را هم وارد مرحله بازیابی کند. با این حال پیدا کردن تصویر مشابه با اثبات مشخصات محصول برابر نیست. شماره مدل، رنگ دقیق و تعداد درگاه را بهتر است با داده ساختاریافته و فیلترهای قابل اعتماد نیز بررسی کنید.
مدل embedding کجای RAG قرار میگیرد؟
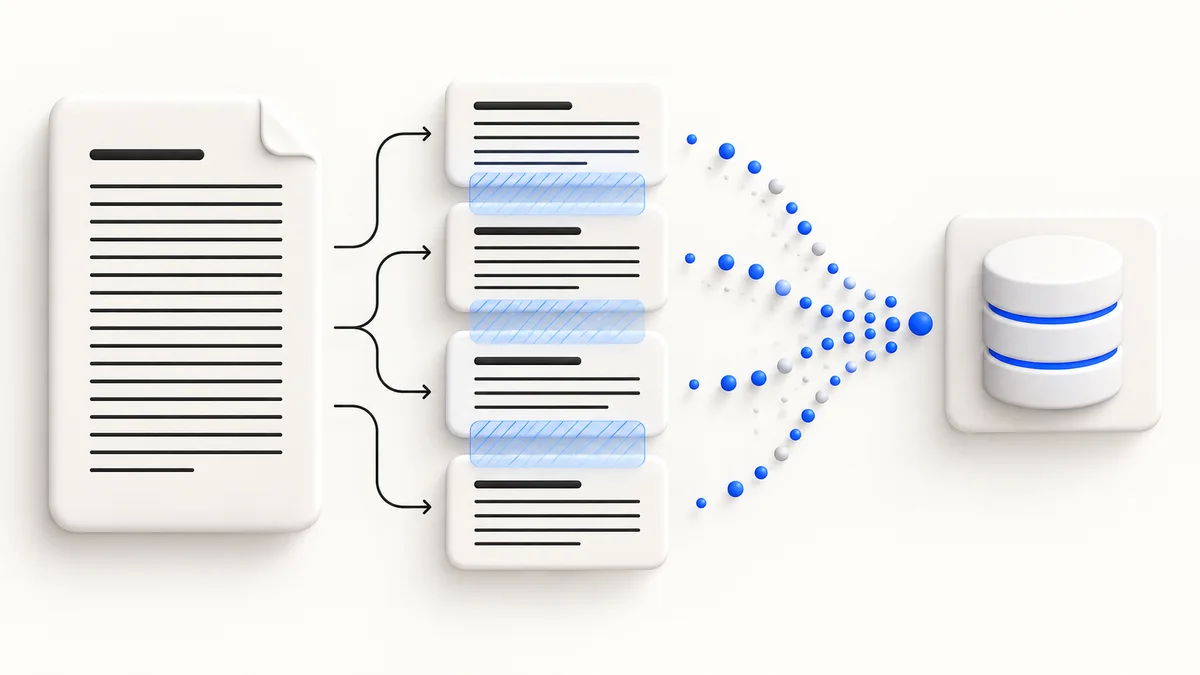
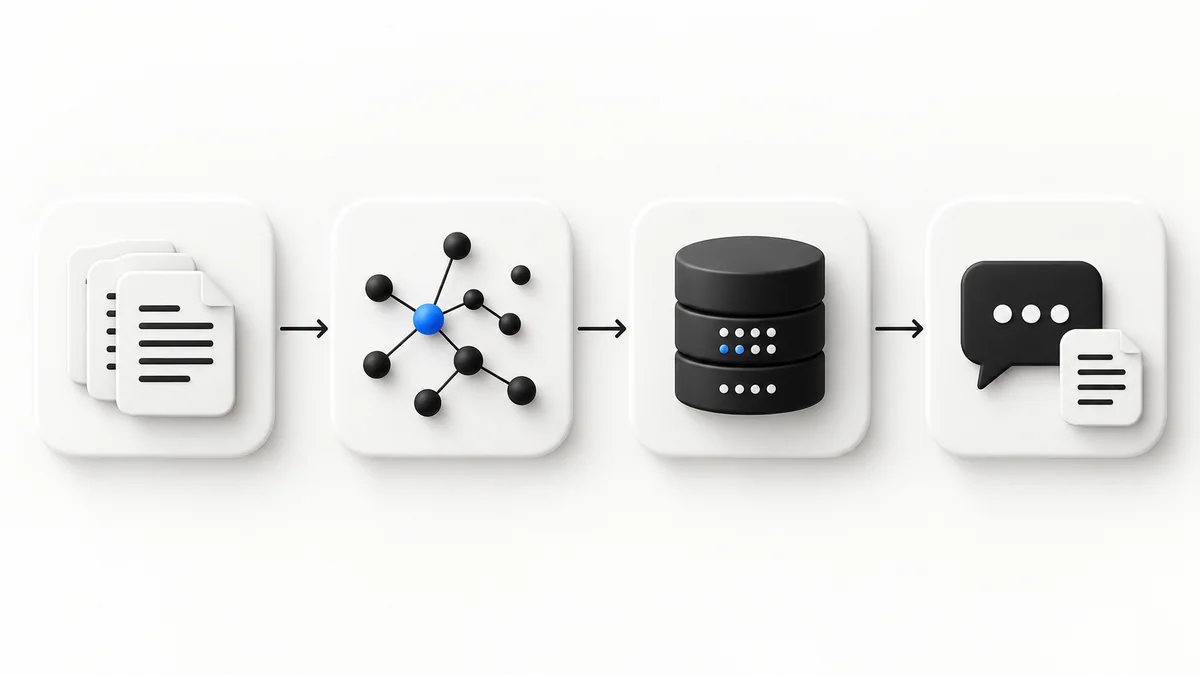
یک مسیر ساده شامل آمادهسازی داده، تولید بردار سند، ساخت نمایه، تولید بردار پرسش، یافتن نامزدهای مرتبط و ساخت پاسخ از روی منابع است. EmbeddingGemma 2 در بخش نمایش برداری و بازیابی قرار میگیرد. مدل پاسخگو پس از آن متن منابع منتخب را میگیرد و پاسخ قابل استناد میسازد. اگر سند مرتبط پیدا نشده، فرستادن متن تصادفی به مدل بزرگتر معمولاً مشکل بازیابی را حل نمیکند.
در محصول، مرحله بازیابی باید پیش از تولید پاسخ قابل مشاهده و ارزیابی باشد. مثلاً مشخص کنید کدام سه سند برگشتهاند، چرا در محدوده مجاز کاربر هستند و آیا پاسخ درست در آنها وجود دارد. سپس صحت پاسخ نهایی و استناد را بسنجید. برای مسیر پایه، آموزش RAG با embedding و pgvector را مطالعه کنید؛ این مقاله روی انتخاب و ارزیابی مدل تازه و داده چندرسانهای تمرکز دارد.
اجرای محلی یا استفاده از API Embedding؟
اجرای محلی به شما کنترل بیشتری روی دریافت داده، نسخه وزنها و زمان پردازش میدهد، اما دانلود مدل، مصرف حافظه، بهروزرسانی و پایش را هم باید مدیریت کنید. عبارت «قابل اجرا روی CPU» به معنی مناسب بودن هر هاست کوچک برای هر حجم فایل نیست. اندازه مدل، طول ورودی، تعداد درخواست همزمان و رمزگشاهای صوت و تصویر روی منابع لازم اثر دارند. حافظه زمان بارگذاری را جدا از مصرف پردازش روزمره اندازه بگیرید.
اگر نگهداری مدل محلی نمیخواهید، مدلهای embedding موجود در مستندات و کاتالوگ پاستا را بررسی کنید. در این انتخاب، API بخش تولید بردار را انجام میدهد و شما همچنان مسئول داده، دسترسی و کیفیت بازیابی هستید. نتیجه یک مدل متنی را با جستوجوی چندرسانهای یک مدل دیگر معادل ندانید. مزیت عملی هر مسیر را با مجموعه داده و محدودیت خودتان بسنجید، نه صرفاً با نام یا اندازه مدل.
نمونه Python برای جستوجوی متن فارسی
برای شروع، سه سند ساختگی و عمومی کافیاند. در یک محیط مجازی، نسخههای سازگار کتابخانهها را طبق کارت مدل نصب کنید. این دستور مدل و وابستگیها را روی محیط خواننده دریافت میکند؛ فضای دیسک و حافظه لازم را پیش از آن بررسی کنید. نمونه از Promptهای مستند جستوجو و سند استفاده میکند و بردارها را نرمال میکند تا ضرب داخلی در همین مثال نقش شباهت کسینوسی را داشته باشد.
python -m pip install -U sentence-transformers transformers numpyfrom sentence_transformers import SentenceTransformer
import numpy as np
model = SentenceTransformer("google/embeddinggemma-2", device="cpu")
documents = [
"برای انتشار دوباره برنامه، داده مهم را در فضای پایدار نگه دارید.",
"صفحه تسویه حساب فروشگاه نباید وارد کش مشترک کاربران شود.",
"کلید API مدل را در بکاند و متغیر محیطی خصوصی نگه دارید.",
]
vectors = model.encode(
documents, prompt_name="Document", normalize_embeddings=True
)
query = model.encode(
["بعد از استقرار دوباره فایلهایم باقی میمانند؟"],
prompt_name="SearchQuery", normalize_embeddings=True,
)
scores = vectors @ query[0]
for index in np.argsort(-scores)[:3]:
print(int(index), float(scores[index]), documents[index])این کد یک نمونه آموزشی است و نتیجه رتبهبندی آن در این انتشار با دانلود واقعی وزنها اندازهگیری نشده است. اگر نام Prompt در نسخه نصبشده موجود نیست، بهجای حذف بیصدای آن، نسخه و کارت همان مدل را بررسی کنید. ورودی سند و ورودی پرسش ممکن است قالب متفاوتی بخواهند. پس از اولین اجرای موفق، نسخه وابستگیها و شناسه دقیق مدل را ثبت کنید تا تغییر محیط، نتیجه مقایسه را نامعلوم نکند.

نظرات کاربران (۰)
هنوز نظری ثبت نشده است. اولین نفر باشید.